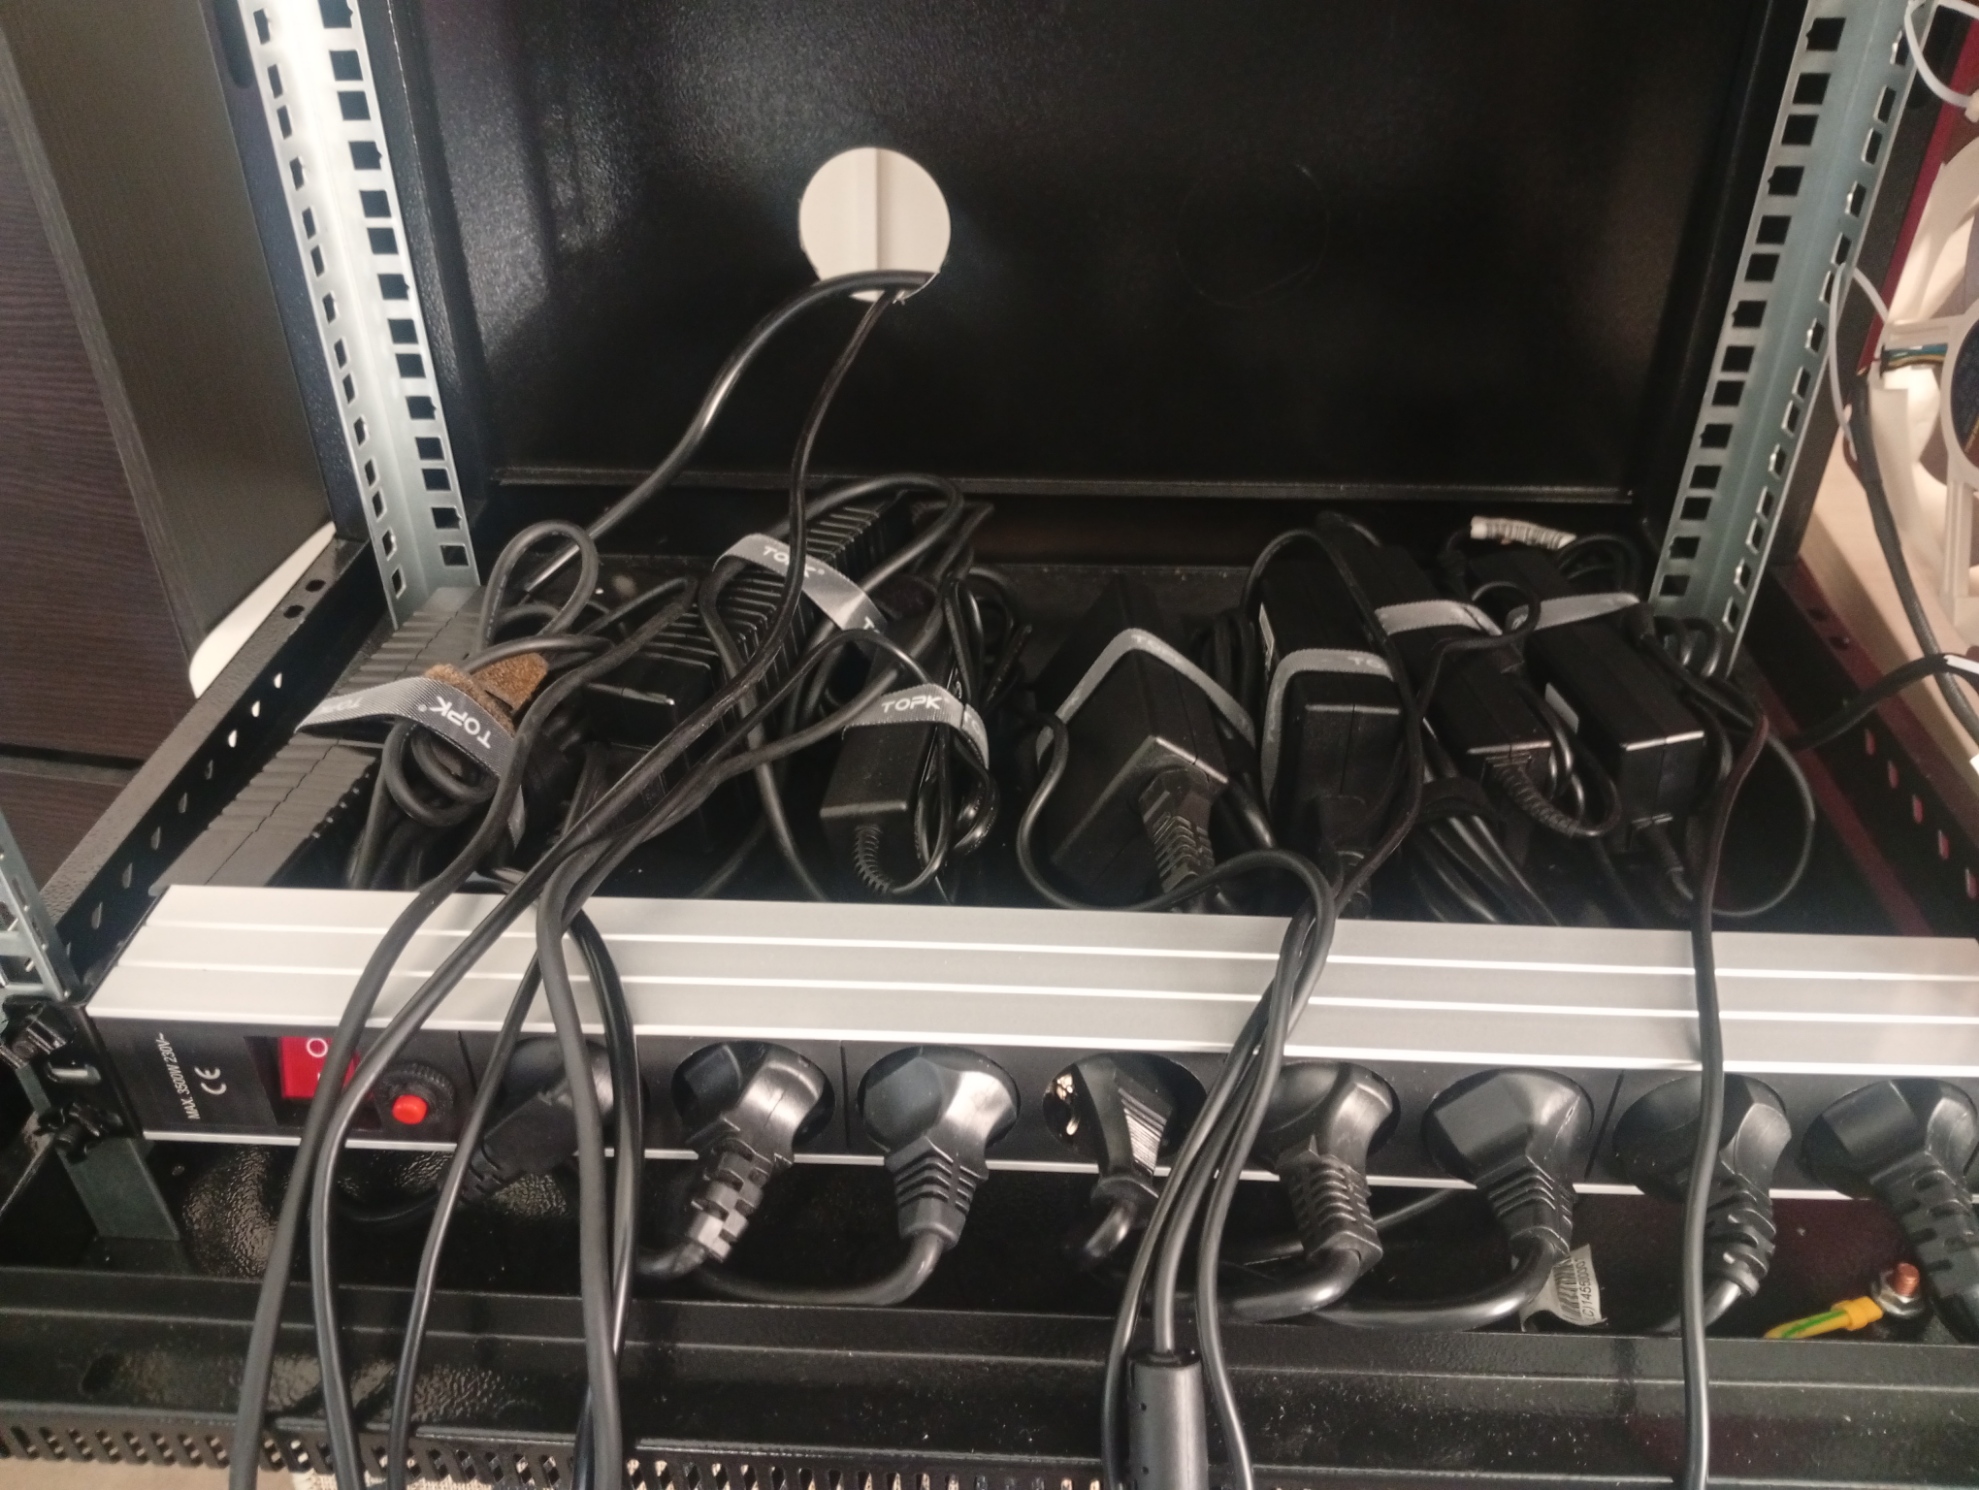
Je me suis donc fixé un objectif simple : construire un vrai data center, à petite échelle, chez moi, y faire tourner mes propres applications et héberger mes sites personnels — gratuitement, sur le long terme, sans dépendre d'une facture cloud mensuelle.
Trois objectifs ont guidé chacune de mes décisions :
Apprendre — toucher moi-même chaque couche : matériel, réseau, pare-feu, virtualisation, Kubernetes, stockage, bases de données, CI/CD, supervision et sécurité.
Comprendre — pas seulement « ça marche », mais pourquoi ça marche, et ce qui se passe quand ça ne marche plus.
Héberger gratuitement, sur la durée — mes propres sites et outils, sur du matériel qui m'appartient, avec l'électricité pour seul coût.
Ce qui a commencé par « je vais installer une ou deux applis » est devenu une plateforme complète de plus de 40 services, construite comme les entreprises construisent la leur — juste en plus petit.
Le matériel : ce qu'il y a vraiment dans la baie
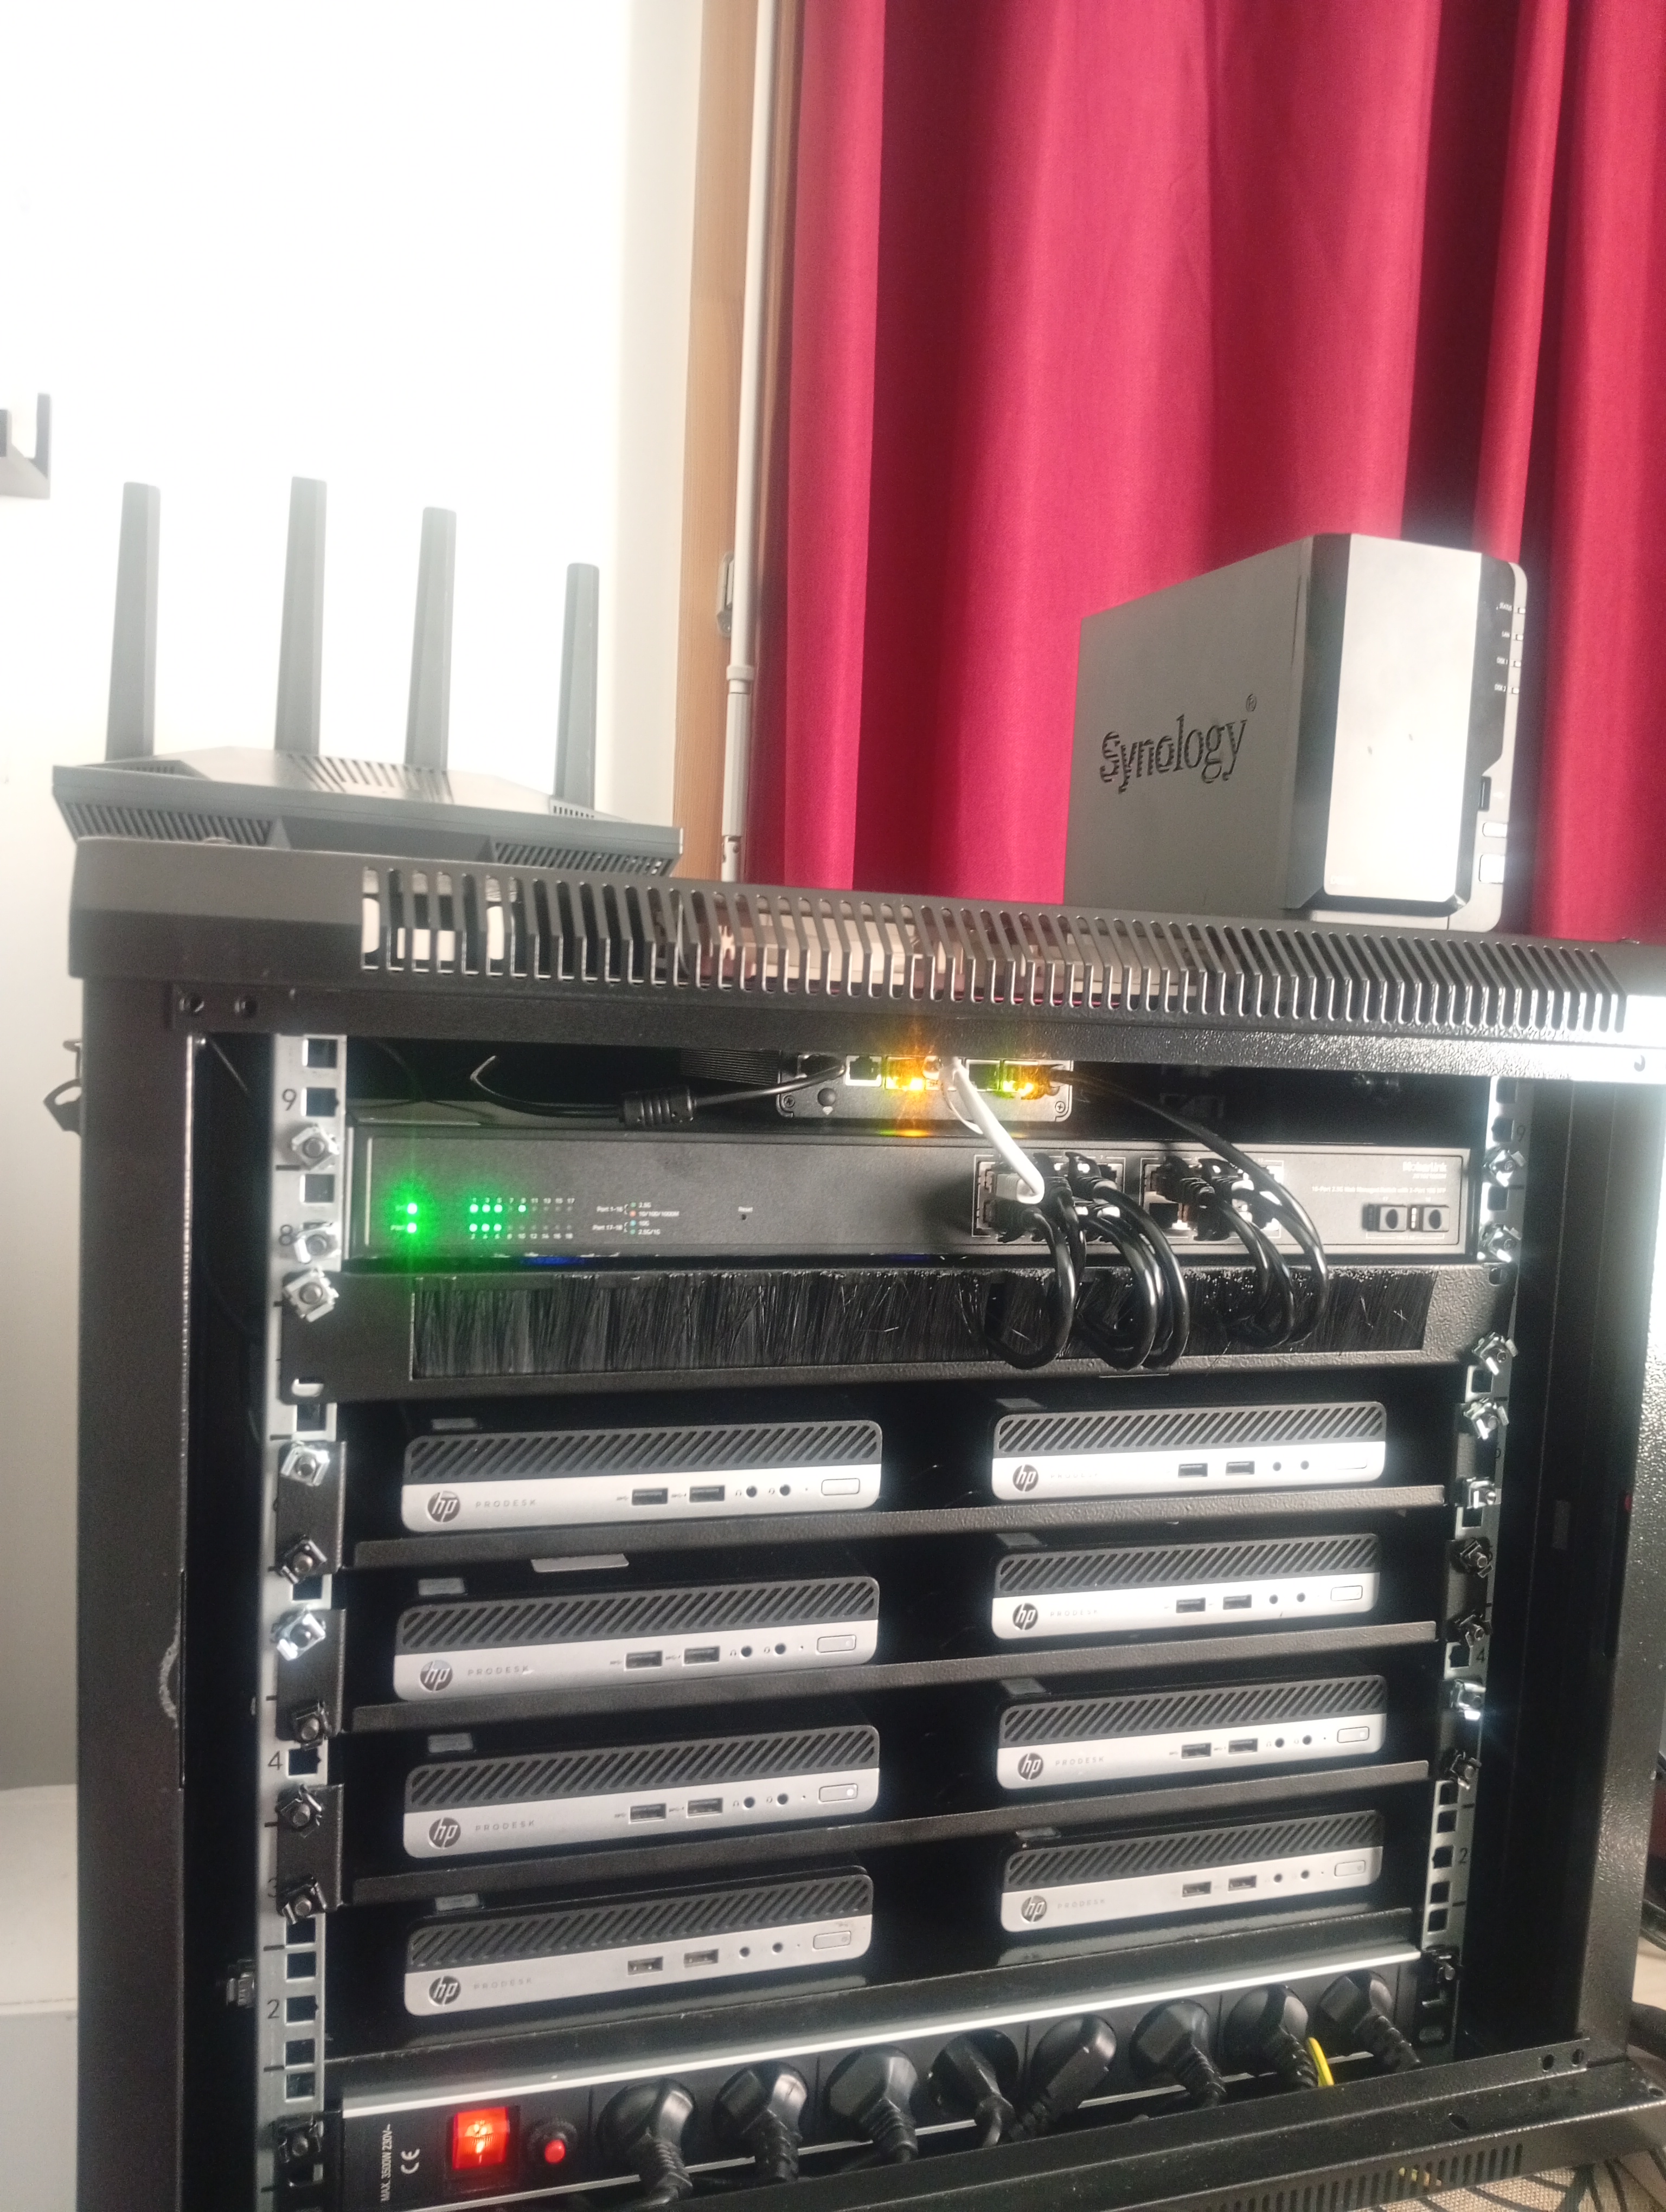
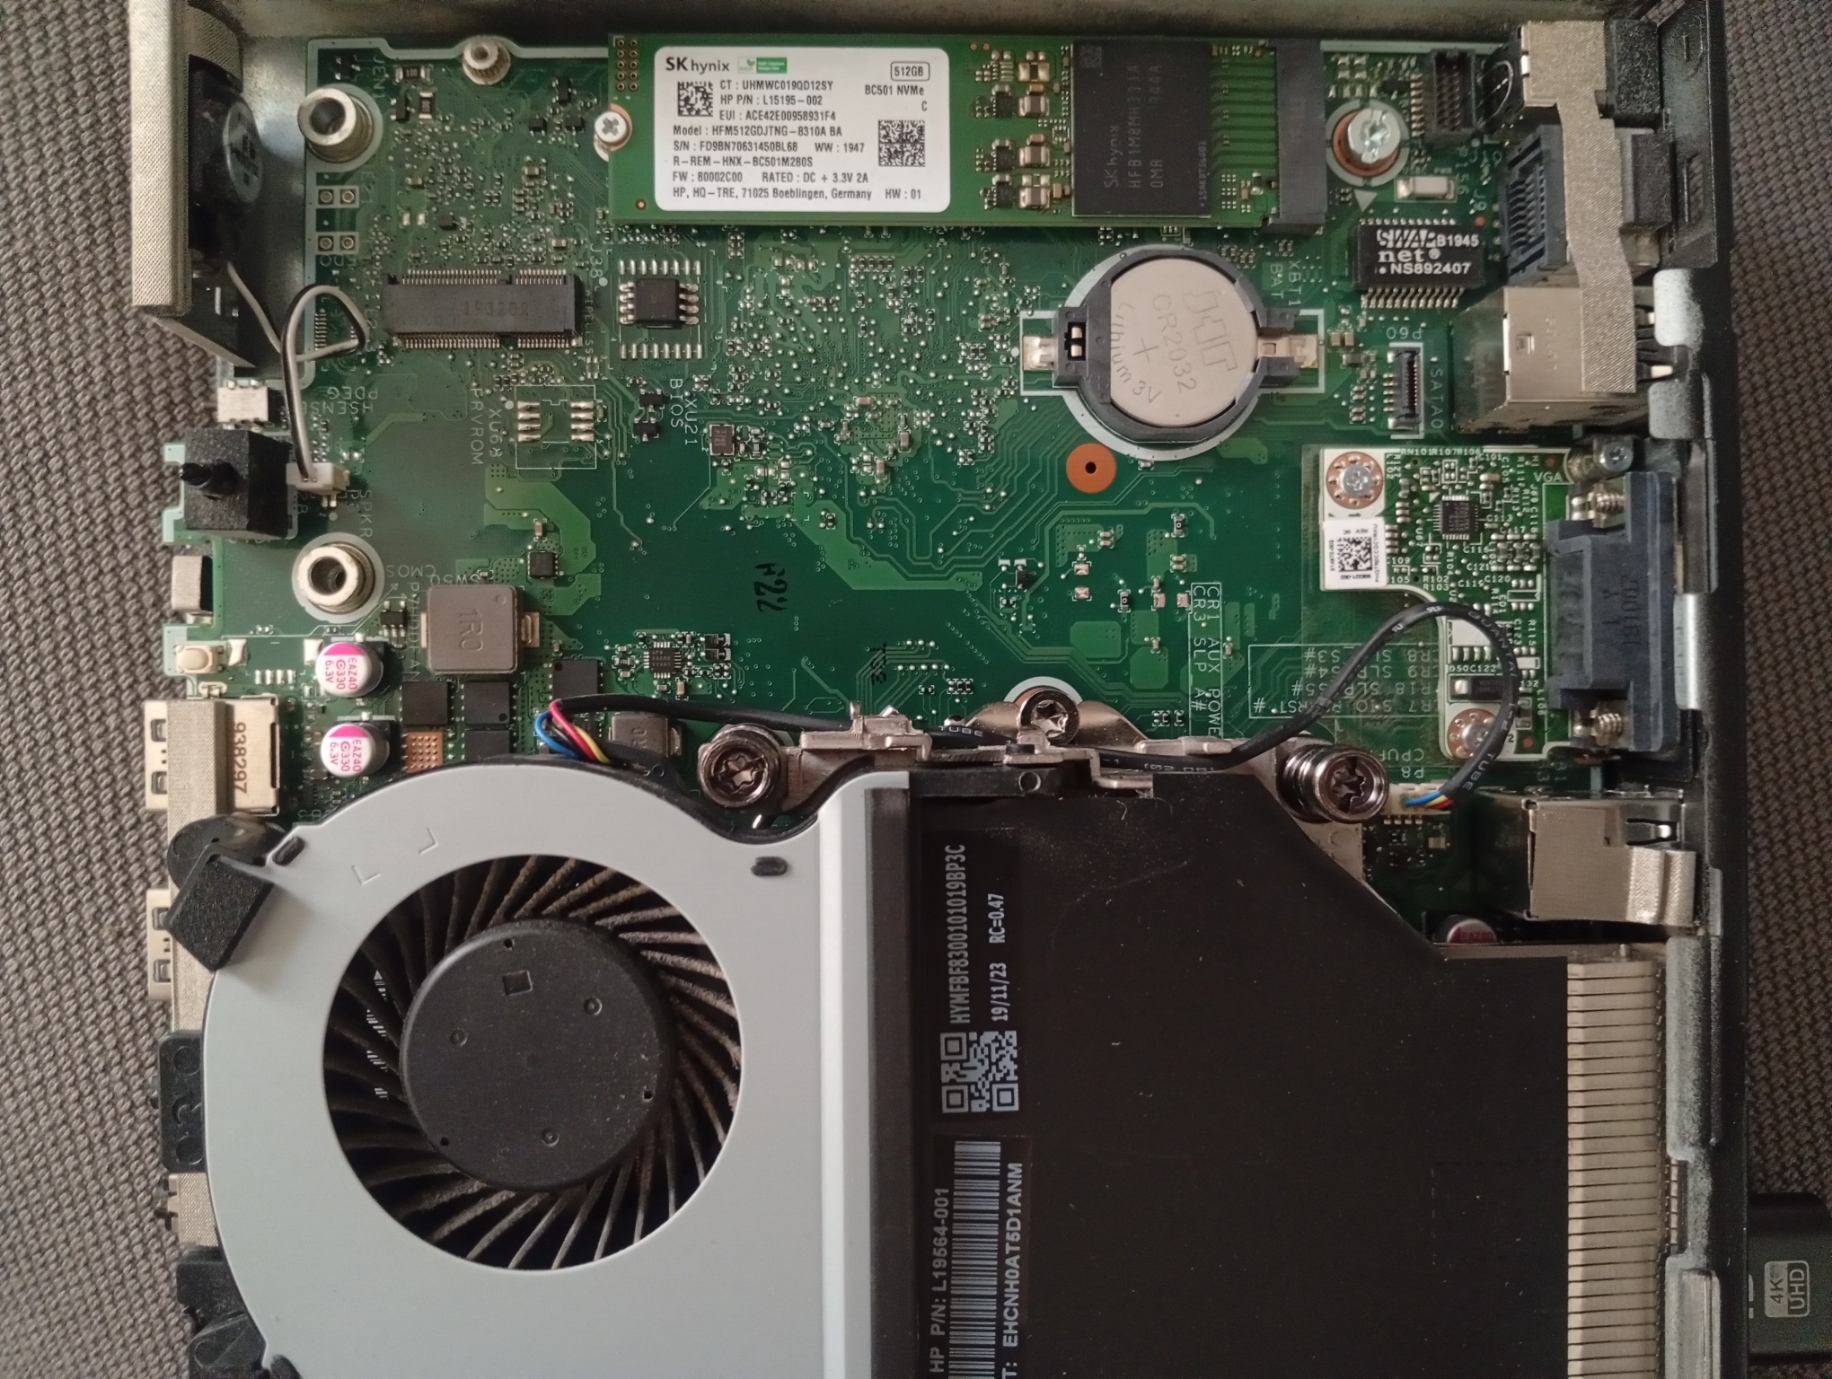
Je n'ai pas acheté de serveurs d'entreprise. J'ai choisi des mini-PC de gamme professionnelle : silencieux, sobres en énergie, peu chers à remplacer, et largement assez puissants quand plusieurs travaillent ensemble. C'est tout le principe d'un cluster : beaucoup de machines modestes plutôt qu'une seule grosse machine coûteuse.
|
Composant |
Ce que j'ai |
Son rôle |
|
Serveurs |
8 mini-PC : 6 avec un Intel Core i5 de 9ᵉ génération et 2 avec un Intel Core i5 de 6ᵉ génération |
Nœuds Kubernetes, hôte de virtualisation et serveur de bases de données |
|
Mémoire |
5 serveurs avec 32 Go de RAM et 3 serveurs avec 16 Go — plus de 200 Go au total |
De quoi faire tourner plus de 40 services, avec de la marge |
|
Pare-feu |
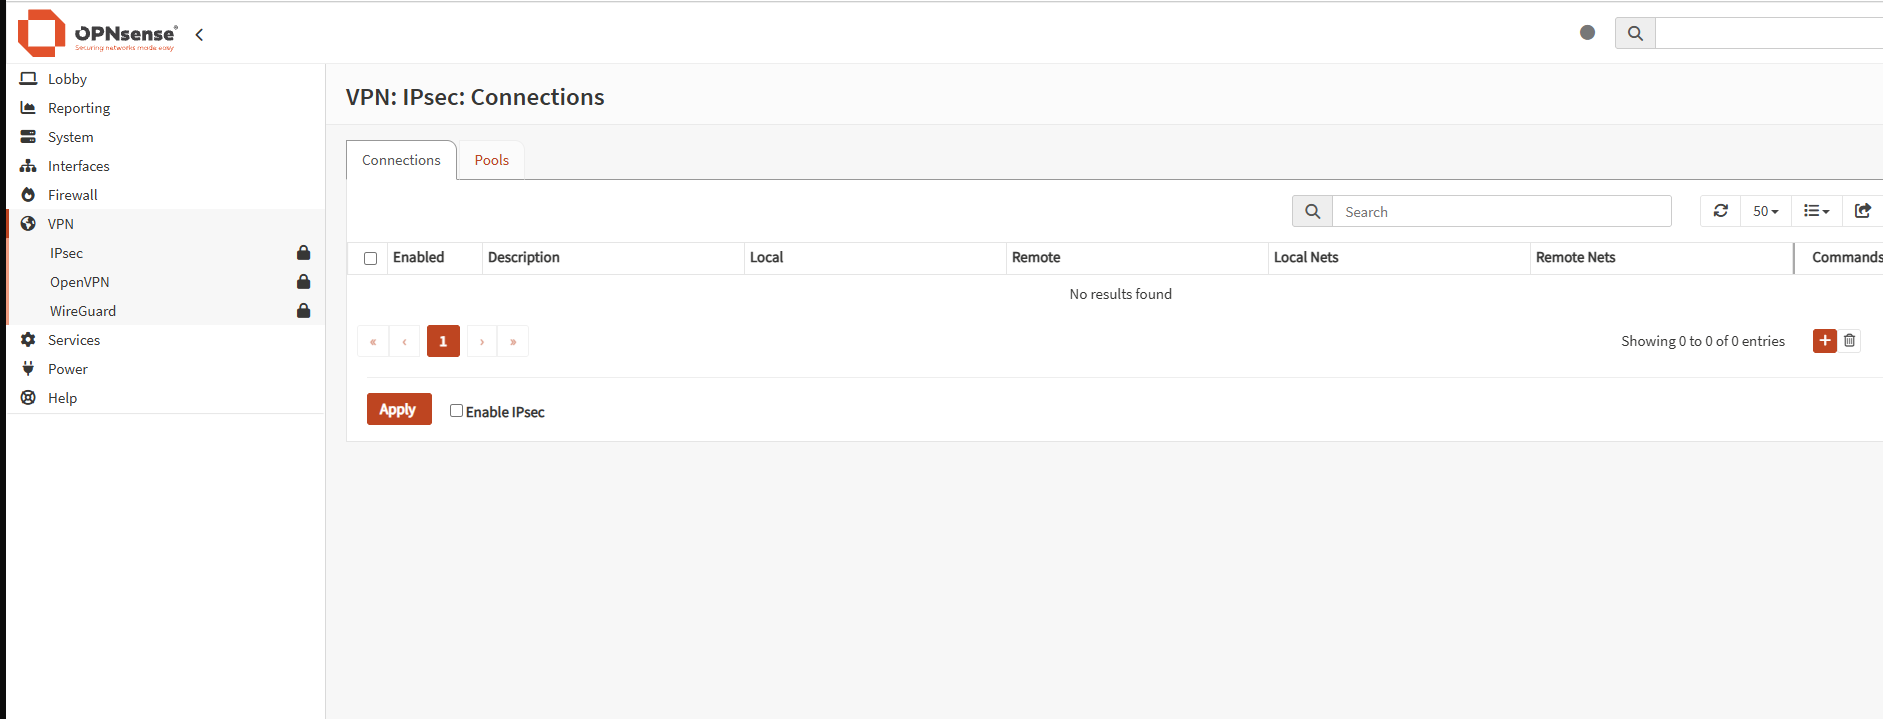
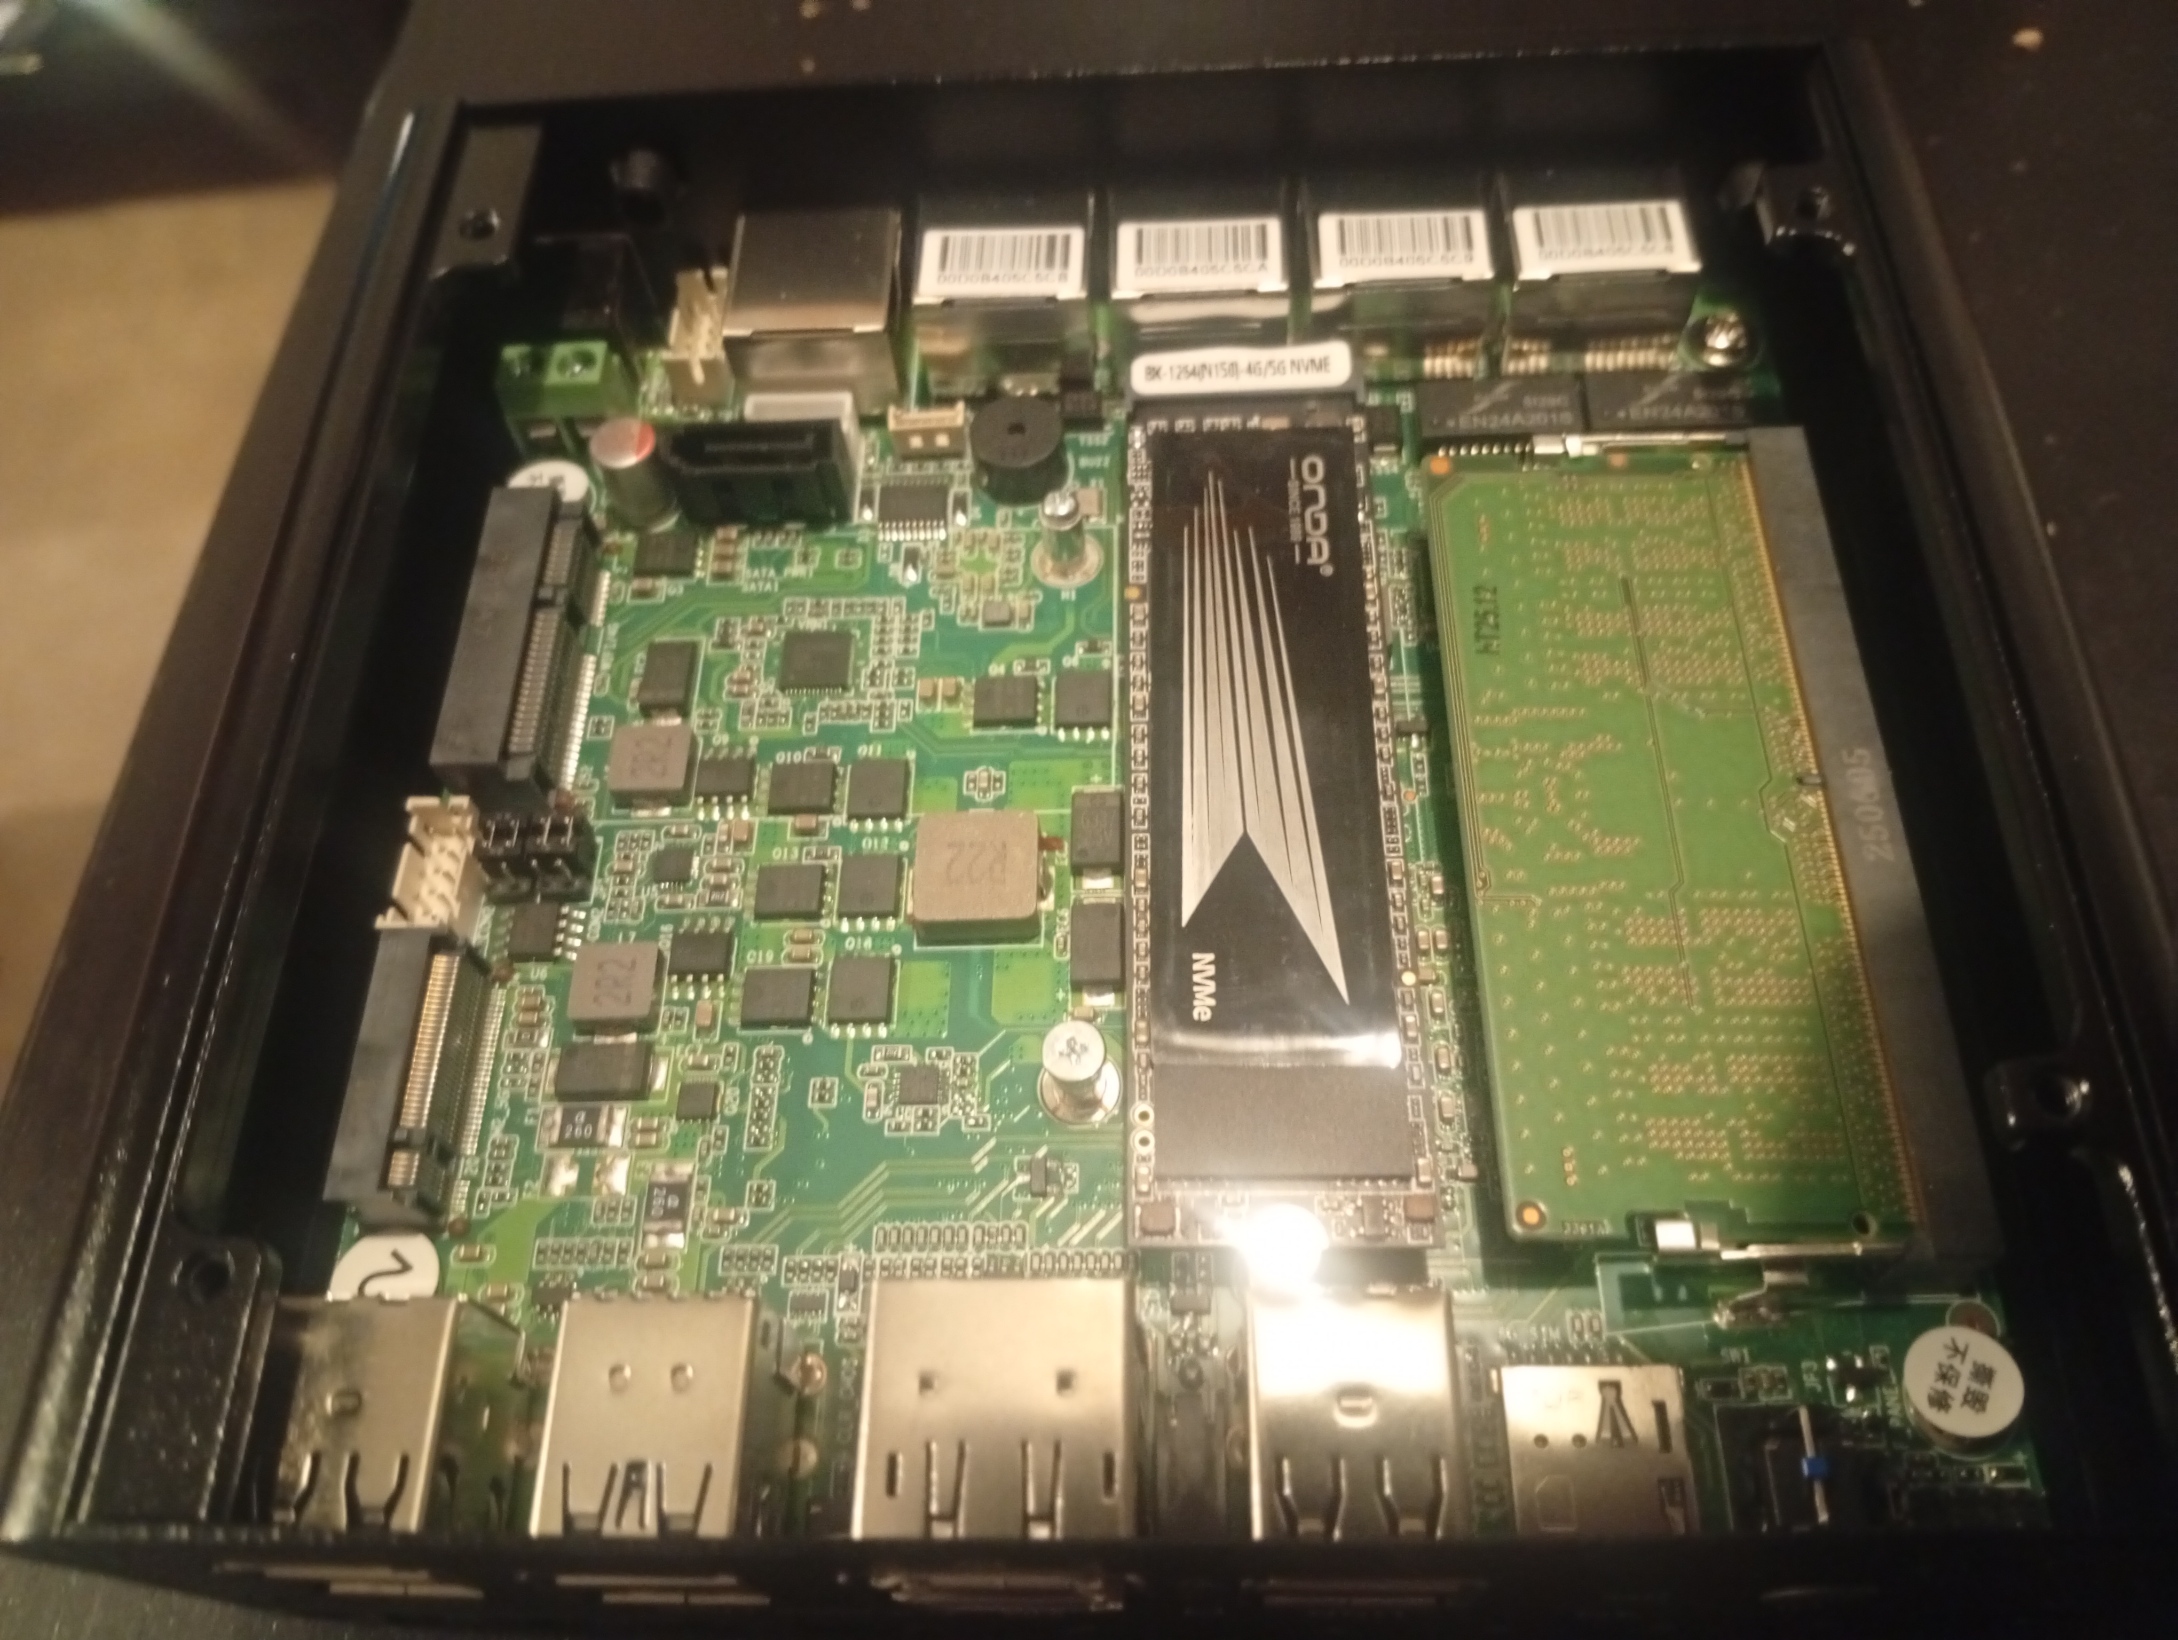
Un boîtier dédié sans ventilateur, processeur Intel N150, sous OPNsense
|
Le gardien entre chaque zone et Internet |
|
Switch |
Un switch administrable 16 ports 2,5 Gb |
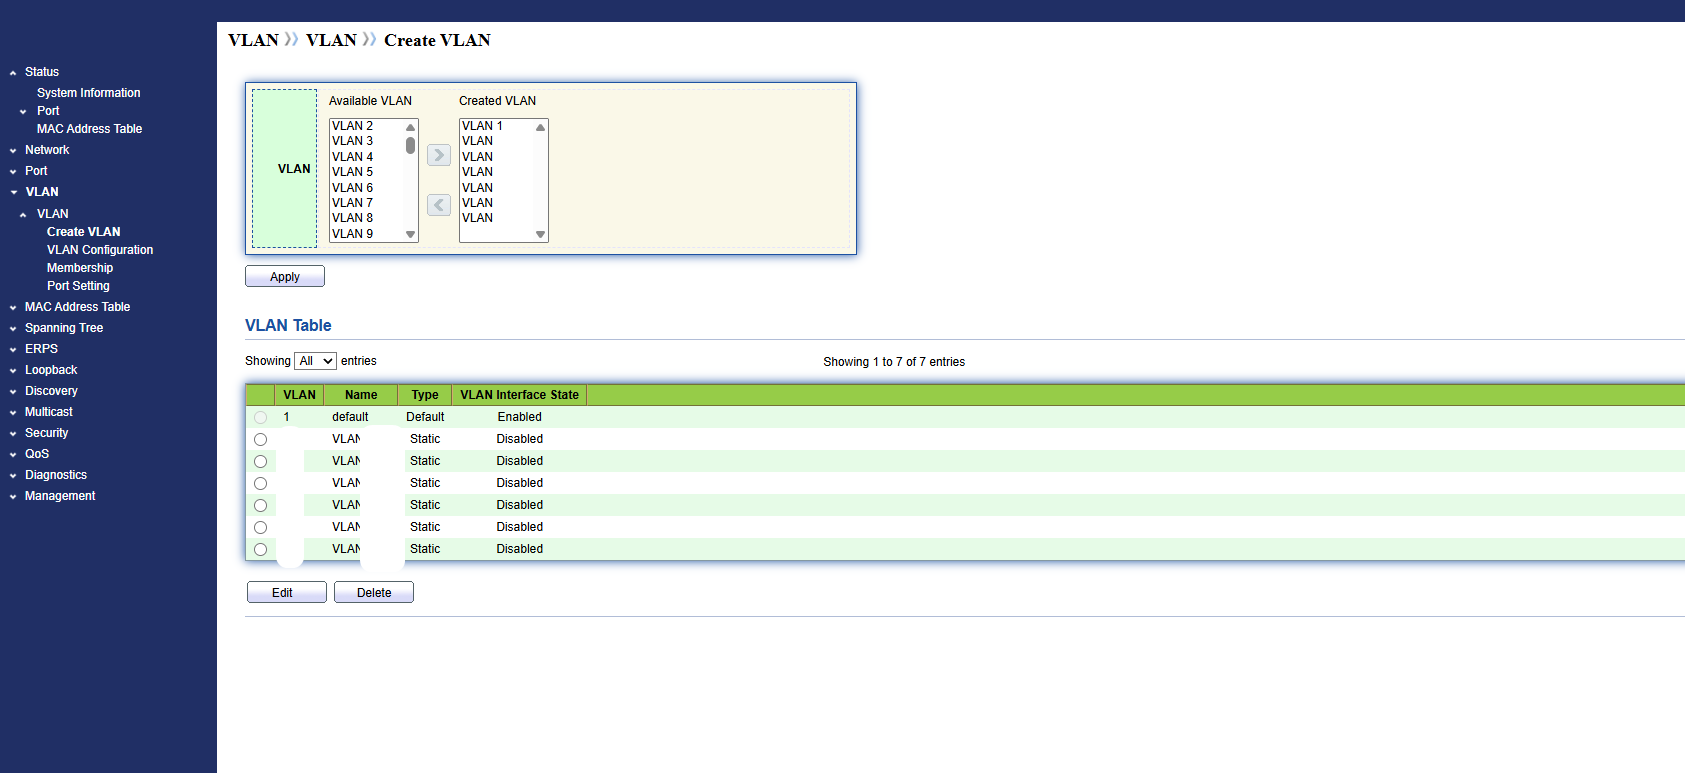
Transporte toutes les zones réseau (VLAN) sur les mêmes câbles |
|
Cartes réseau |
Des adaptateurs USB 2,5 Gb UGREEN sur les serveurs |
Les mini-PC sont livrés avec des ports 1 Gb ; ces adaptateurs les passent à 2,5 Gb pour la réplication du stockage et les transferts rapides |
|
Wi-Fi |
Un point d'accès Wi-Fi 6 dédié |
L'accès sans fil, isolé dans sa propre zone réseau |
|
Stockage |
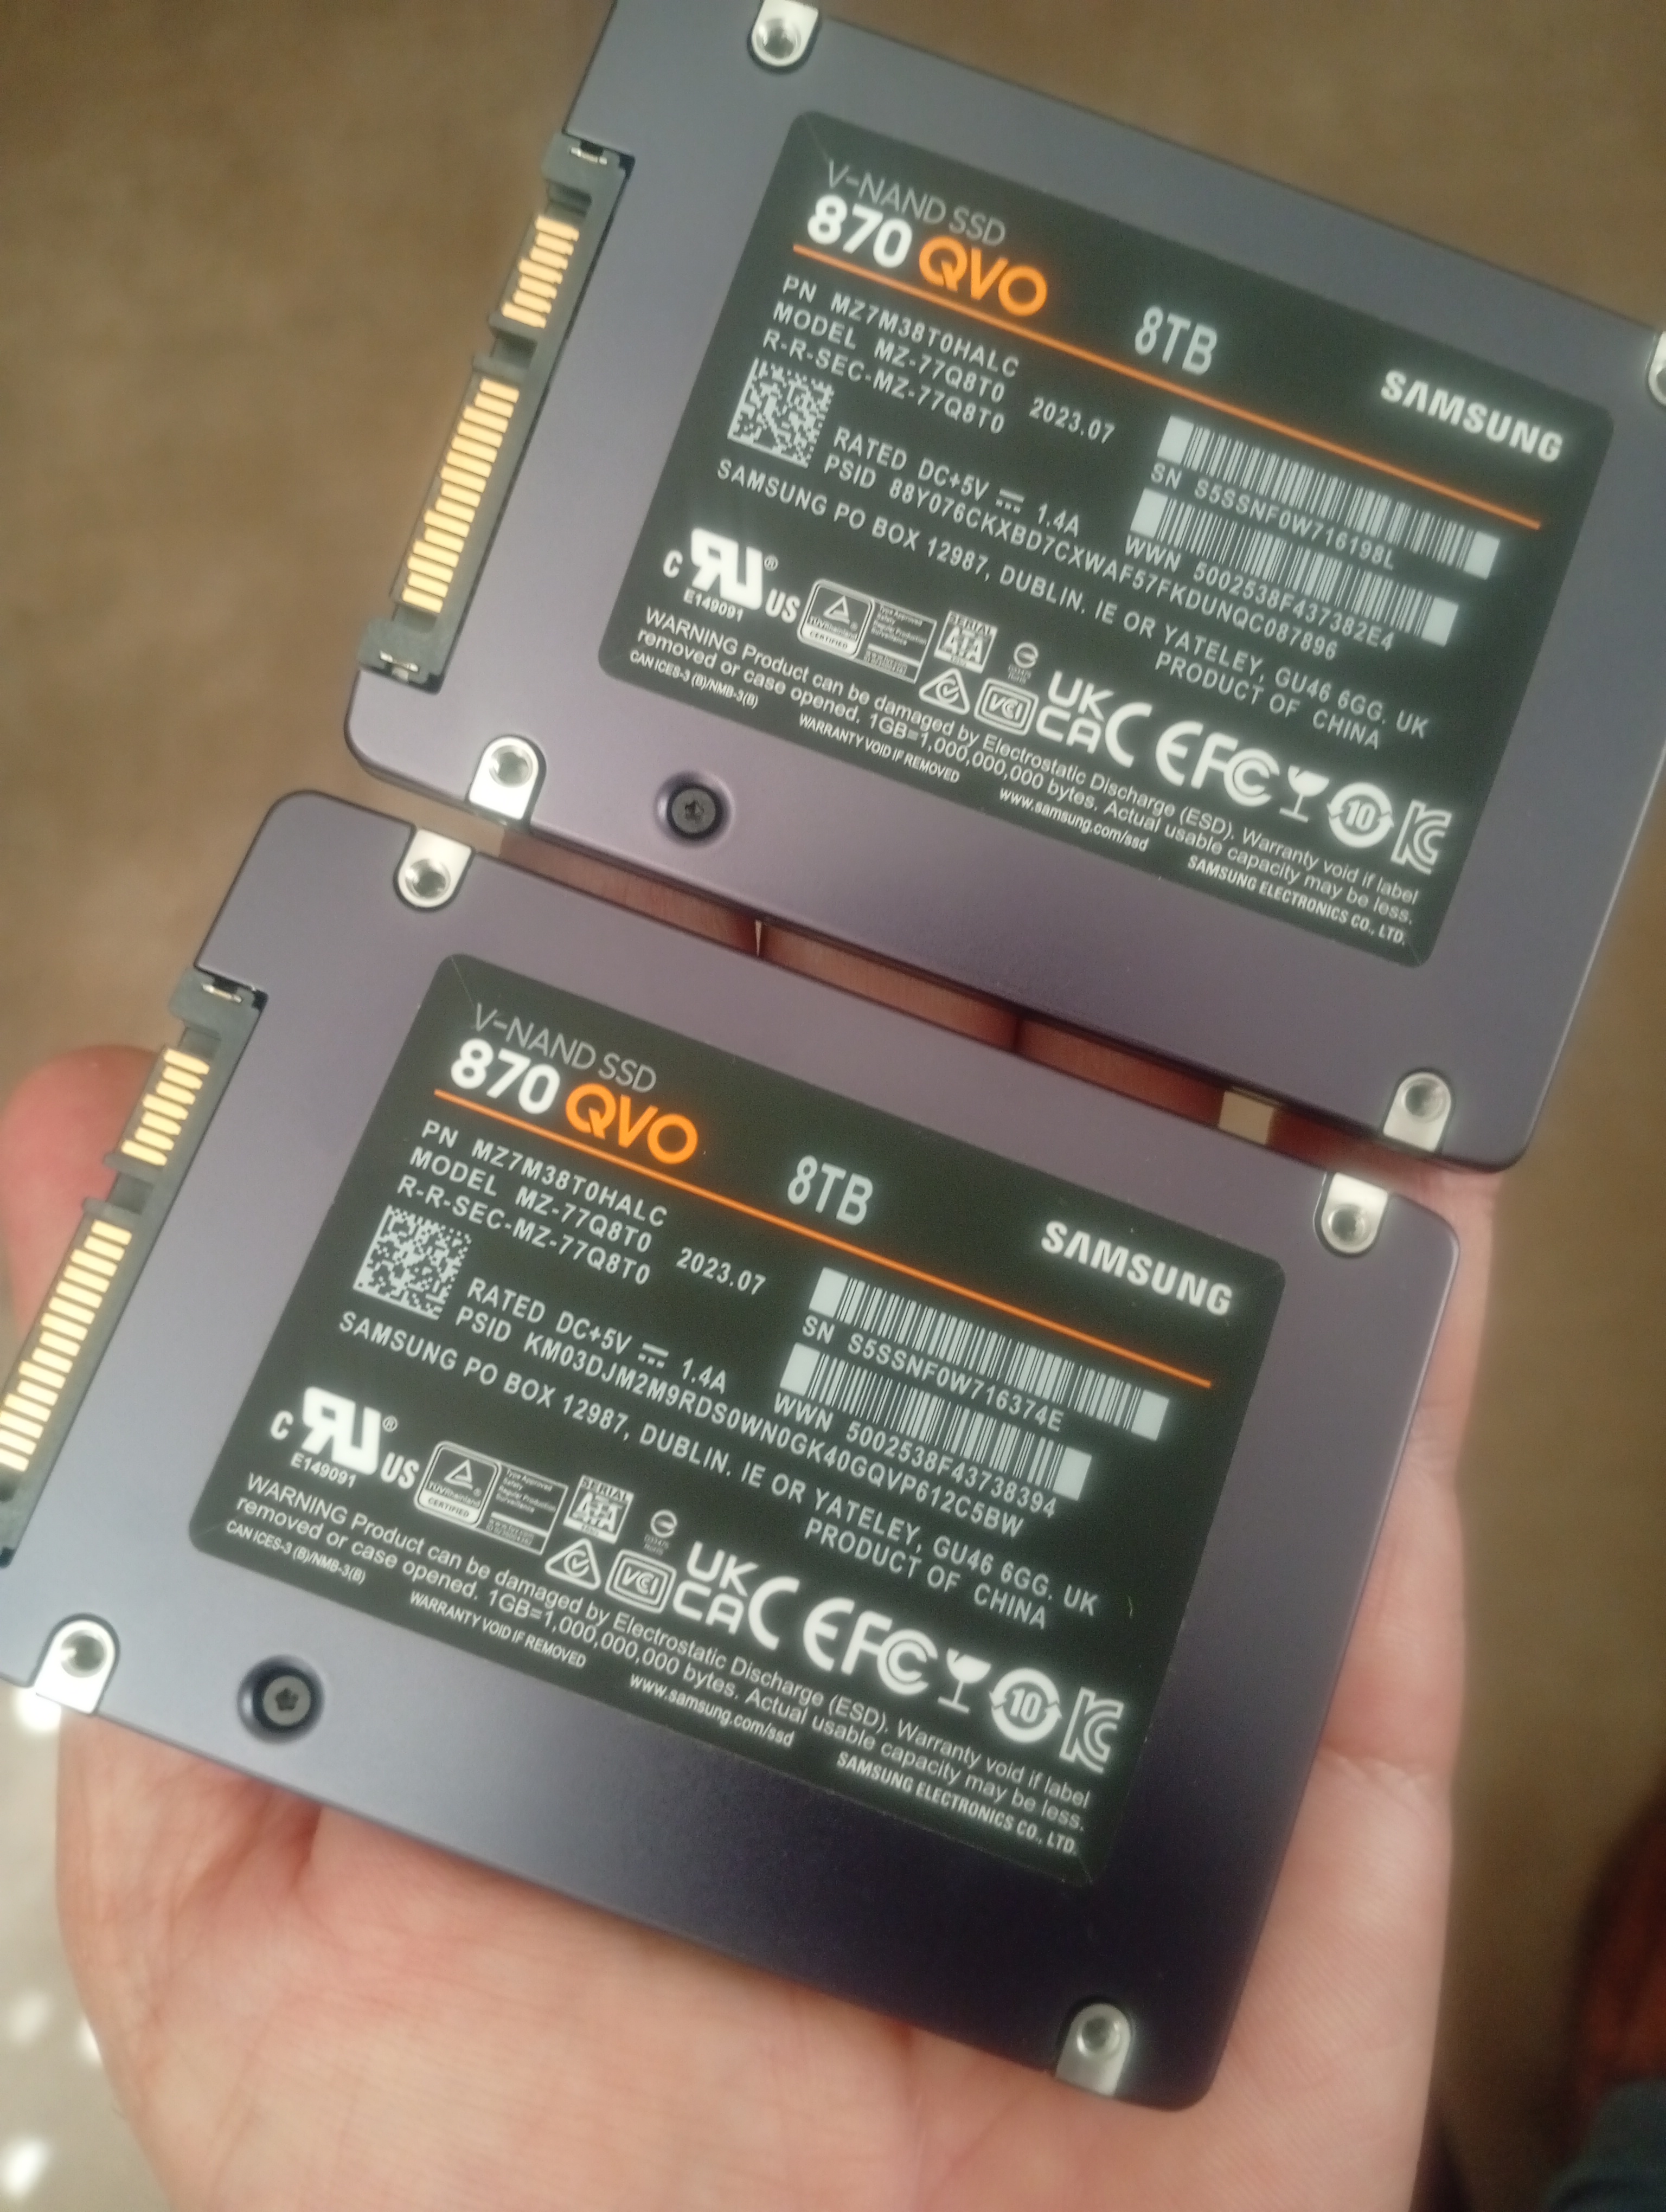
Environ 28 To de capacité brute répartis entre les serveurs et le NAS — une partie encore libre pour de futurs projets |
Données des applications, médias, photos, documents et sauvegardes |
|
NAS |
Un NAS Synology |
Fichiers partagés, et cible centrale des sauvegardes |
Investissement total à ce jour : environ 5 000 €, étalés dans le temps. Ça paraît beaucoup d'un coup, mais comparez avec ce que coûteraient chaque mois 8 serveurs, 200 Go de RAM et 28 To de stockage dans un cloud public : le matériel se rembourse, puis continue de tourner pendant des années.
Le réseau 2,5 Gb s'est révélé être l'une des meilleures améliorations : le stockage répliqué copie chaque écriture sur plusieurs nœuds, et avec des liens à 1 Gb, le réseau était le goulot d'étranglement. Un bon switch administrable et quelques adaptateurs USB ont réglé le problème pour une fraction du prix de nouveaux serveurs.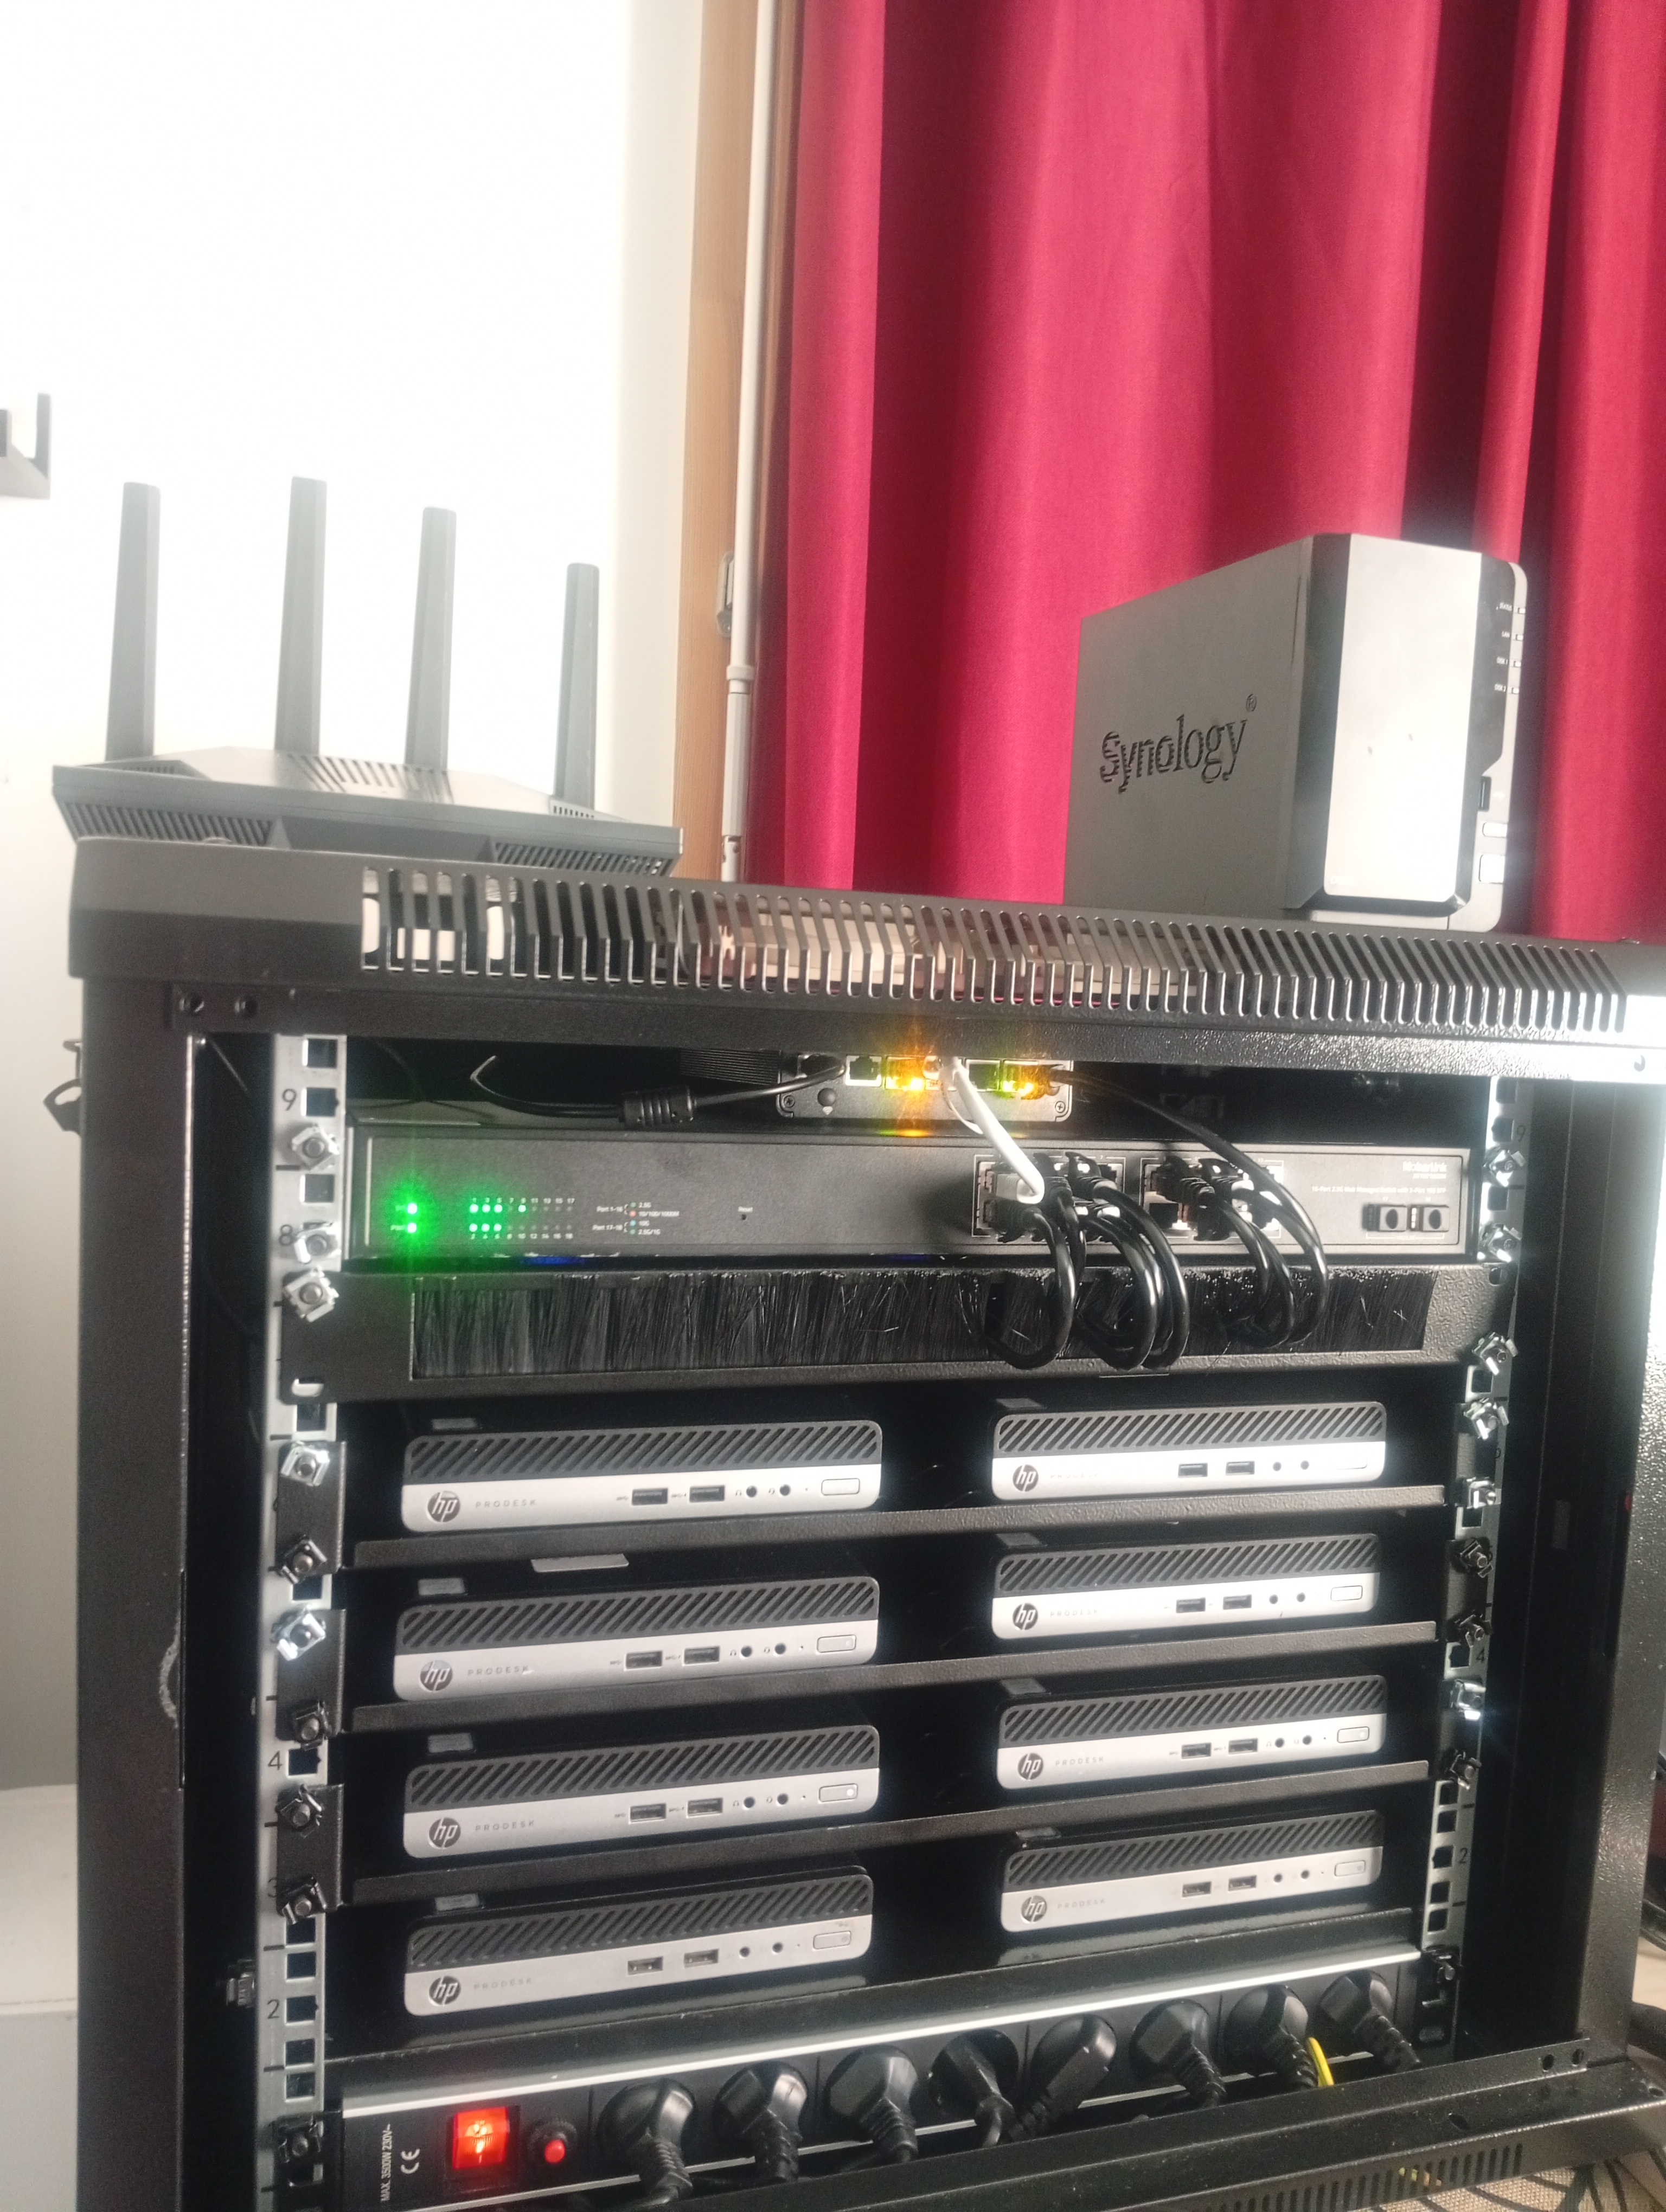
Vue d'ensemble
S'il fallait tout résumer en une phrase : un réseau segmenté par un pare-feu, un hôte de virtualisation, un cluster Kubernetes hautement disponible, un serveur de bases de données dédié et une porte d'entrée vers Internet protégée — le tout géré sous forme de code.
Voici comment les couches s'empilent, du câble jusqu'au navigateur :
| Couche | Ce que j'utilise | Pourquoi c'est important |
|---|---|---|
| Matériel | 8 mini-PC Core i5 (plus de 200 Go de RAM), un pare-feu N150, un switch administrable 2,5 Gb, un point d'accès Wi-Fi 6, un NAS — environ 28 To au total | De vraies machines, de vraies pannes, un vrai apprentissage — pour un coût électrique faible |
| Réseau | Des réseaux virtuels (VLAN) séparés par rôle | Un problème dans une zone ne peut pas se propager aux autres |
| Pare-feu | OPNsense, configuré avec Terraform | Chaque règle est écrite en code, relue, versionnée et reproductible |
| Virtualisation | Proxmox | Fait tourner les machines virtuelles qui n'ont pas leur place dans Kubernetes |
| Orchestration | Kubernetes (k3s), plusieurs nœuds de contrôle + des nœuds de travail | Les applications survivent à la perte d'une machine |
| Stockage | Longhorn (stockage bloc répliqué) + NAS (fichiers partagés) | Les données sont copiées sur plusieurs nœuds, pas enfermées sur un seul disque |
| Bases de données | Un serveur de bases de données dédié (PostgreSQL), un cache partagé (Redis) | Les données vivent à part du calcul — comme en production |
| Livraison | Git → CI → registre privé → GitOps | Rien n'est installé « à la main » sur le cluster |
| Observabilité | Prometheus, Grafana, Loki | Je vois ce qui se passe, et je suis prévenu quand ça ne va pas |
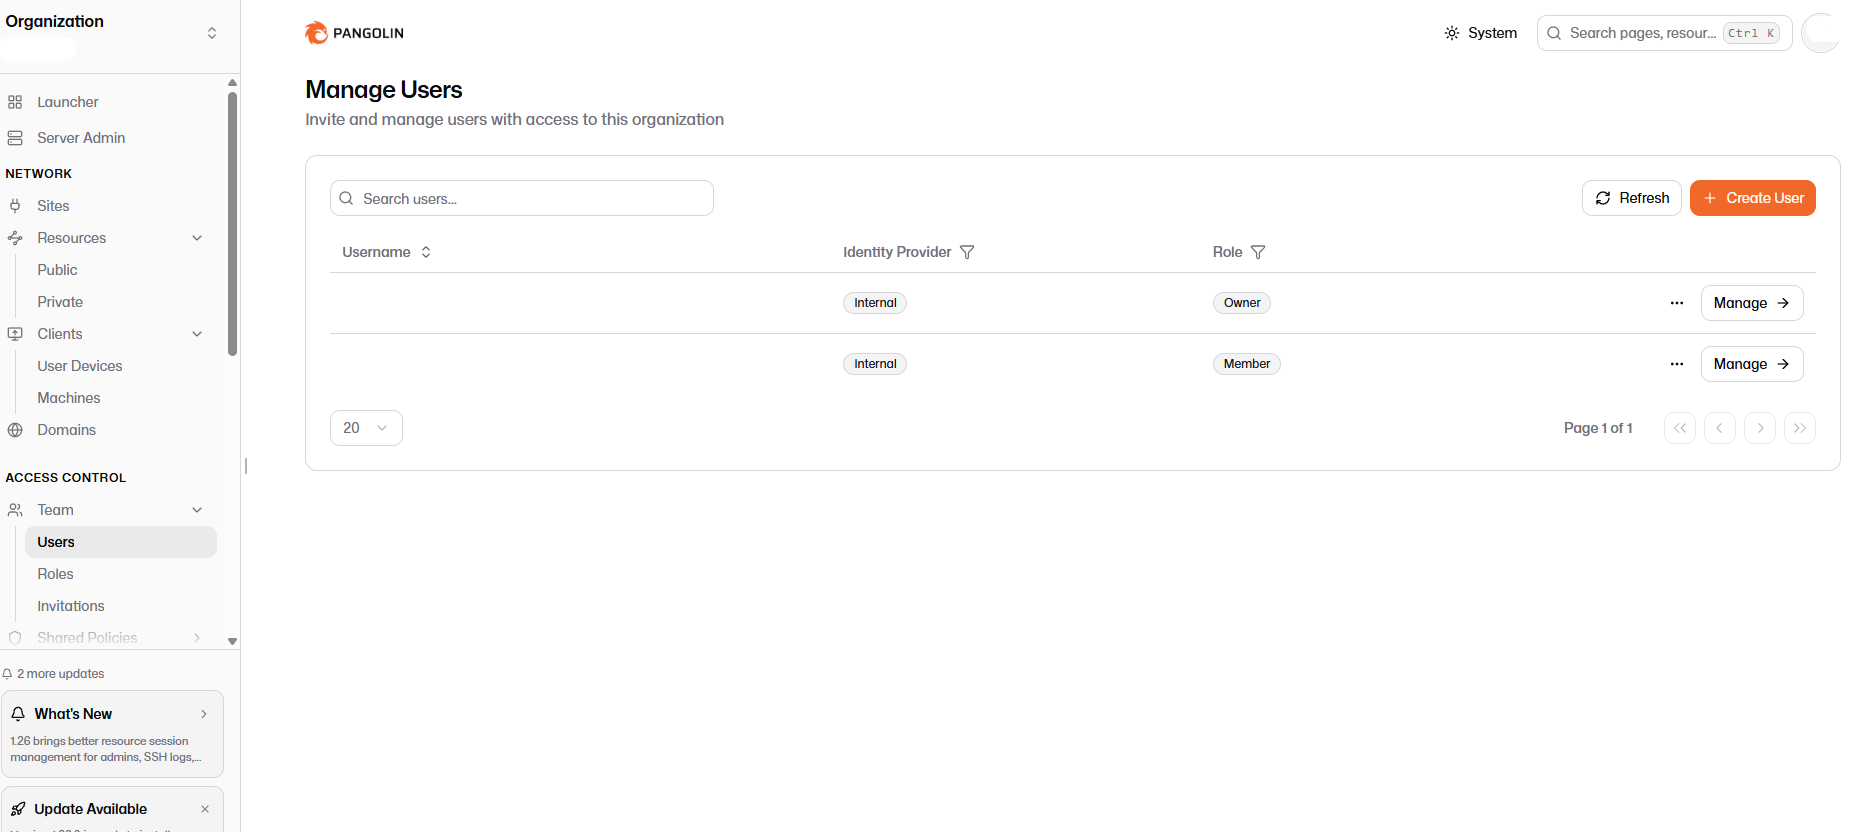
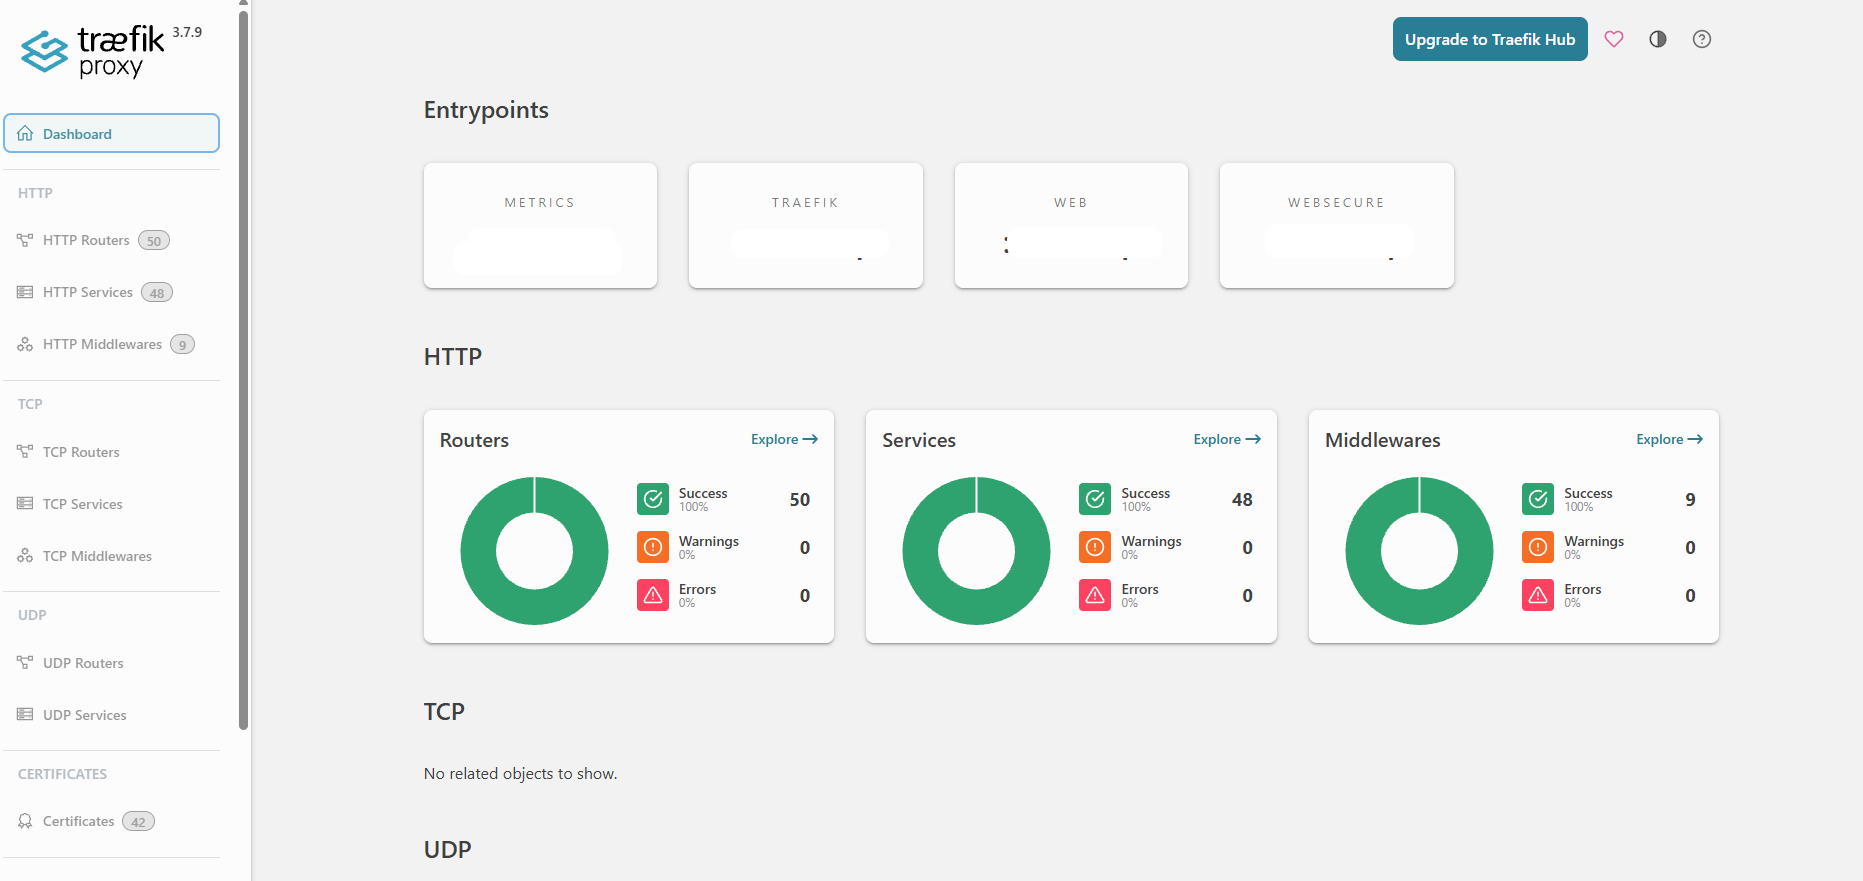
| Accès & sécurité | Proxy inverse, WAF, réputation d'IP, SSO, VPN | Plusieurs couches indépendantes entre Internet et mes données |
Couche 1 — Le réseau : des zones, pas un grand réseau à plat
La plupart des réseaux domestiques forment un seul espace à plat : votre téléphone, votre télé et vos serveurs se voient tous entre eux. Je voulais l'inverse.
J'ai découpé le réseau en zones séparées, chacune avec un seul rôle. Le switch administrable 2,5 Gb les transporte toutes sur les mêmes câbles (chaque zone est un VLAN), et c'est le pare-feu qui décide qui a le droit de parler à qui :
| Zone | Qui y vit | Ce qu'elle a le droit de faire |
|---|---|---|
| Maison | Les appareils du quotidien : ordinateurs, téléphones, télé | Utiliser Internet et les applications |
| Applications | Les nœuds Kubernetes | Servir les applis ; n'atteindre que les services dont elles ont besoin |
| Administration | L'hôte de virtualisation et les interfaces d'administration | Accessible uniquement par l'administrateur |
| Bases de données | Le serveur de bases de données et le NAS | N'accepter que les connexions des applications qui en ont besoin |
| Wi-Fi / Invités | Le point d'accès et les invités sans fil | Internet uniquement — aucun accès à l'intérieur |
| Bordure | L'unique machine exposée à Internet | Atteindre exactement ce qu'il faut pour servir les sites, rien de plus |
| VPN | Moi, quand je ne suis pas à la maison | Accès d'administration, uniquement via un tunnel chiffré |
Le principe est simple : tout est interdit, sauf ce que j'autorise explicitement.
Le Wi-Fi est séparé, lui aussi. Un point d'accès Wi-Fi 6 dédié gère le sans-fil, et il se trouve dans sa propre zone isolée. Un ami qui se connecte au Wi-Fi a un Internet rapide — mais il ne peut voir ni mes serveurs, ni mon NAS, ni mes autres appareils, et ne peut même pas découvrir qu'ils existent. Un téléphone ou un objet connecté compromis reste confiné dans son coin du réseau.
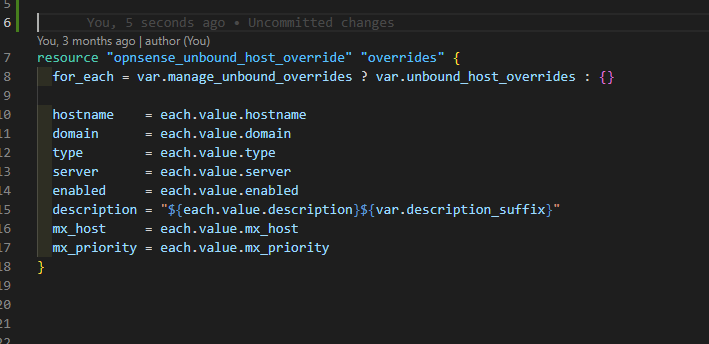
Et la partie dont je suis le plus fier : le pare-feu est configuré avec Terraform. Chaque règle, alias et réservation DHCP vit dans du code. Avant chaque changement, je lance un plan, je lis exactement ce qui va être ajouté ou supprimé, et seulement ensuite je l'applique. Si quelque chose tourne mal, je vois qui a changé quoi, et je peux revenir en arrière.
Couche 2 — La virtualisation et le cluster Kubernetes
Un hôte Proxmox fait tourner les machines virtuelles qui doivent rester en dehors de Kubernetes — par exemple la passerelle exposée à Internet, que je veux isolée de tout le reste.
-Les applications, elles, tournent sur Kubernetes (k3s), réparties sur plusieurs nœuds :
- Plusieurs nœuds de contrôle, pour que le cluster continue de fonctionner si l'un d'eux tombe.
- Des nœuds de travail pour les applications.
- Anti-affinité des pods et budgets d'interruption, pour que deux copies d'une même application ne se retrouvent jamais sur la même machine, et qu'une maintenance ne coupe jamais tout d'un coup.
- Mises à jour progressives : la nouvelle version démarre et devient opérationnelle avant que l'ancienne ne s'arrête.
Je l'ai testé pour de vrai, en débranchant des nœuds et en supprimant des pods pendant que j'utilisais les applis. Voir un site rester en ligne pendant qu'une machine disparaît, c'est le moment où Kubernetes a cessé d'être de la théorie pour moi.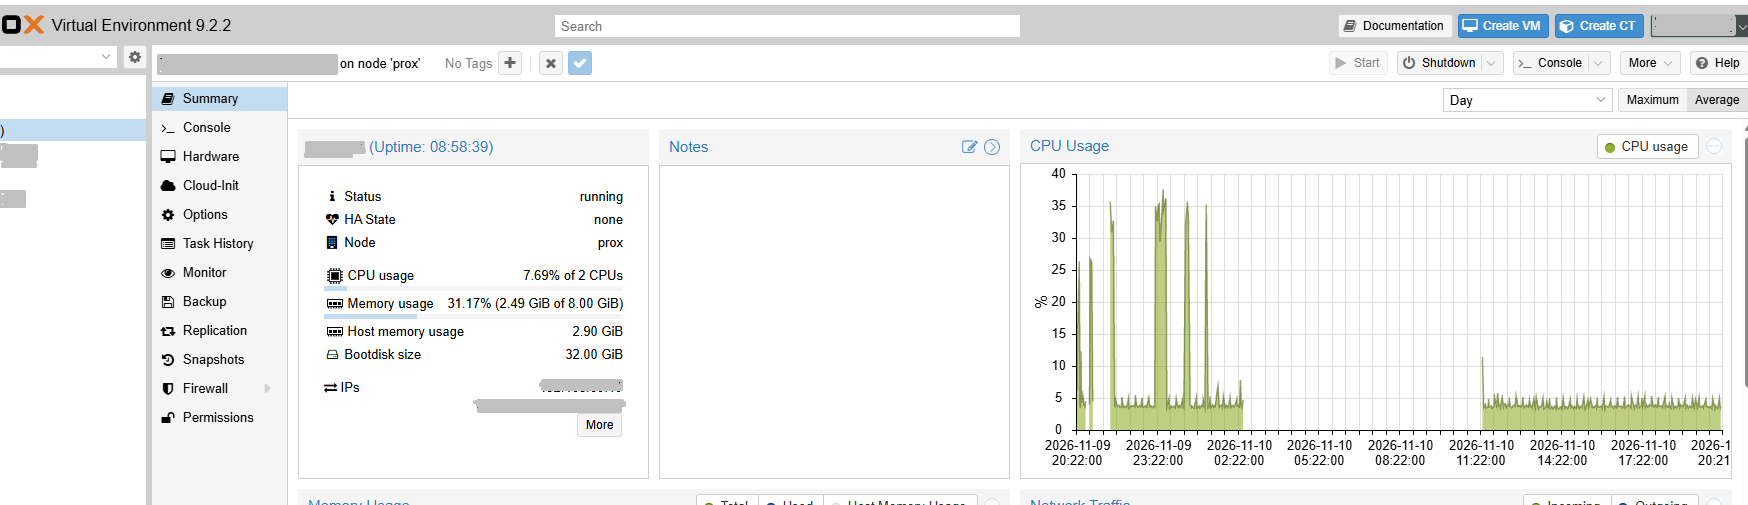
Couche 3 — Stockage, bases de données et cache
C'est là que beaucoup de homelabs prennent des raccourcis, et c'est là que j'ai le plus appris.
Le stockage. Les données des applications sont sur Longhorn, qui conserve des copies de chaque volume sur des nœuds différents. Si un disque ou un nœud meurt, les données existent toujours ailleurs et l'application redémarre sur une machine saine. Les gros fichiers partagés — médias, documents, photos — vivent sur un NAS, monté dans le cluster.
Les bases de données. Au lieu de laisser chaque application embarquer sa petite base dans un conteneur, je fais tourner un serveur de bases de données dédié avec PostgreSQL, sur sa propre machine, dans sa propre zone réseau protégée. Chaque application a sa propre base et son propre utilisateur, avec le strict minimum de droits nécessaires, et les connexions sont chiffrées. C'est exactement comme en production : le calcul peut être détruit et reconstruit, les données restent à l'abri, séparées.
Certains outils légers gardent une simple base embarquée (SQLite) sur leur propre volume répliqué — le bon choix quand une appli n'a jamais qu'un seul écrivain.
Le cache. Un cache Redis est installé à côté du serveur de bases de données. Les applications l'utilisent pour les sessions, les files d'attente et les données temporaires rapides, chacune dans son propre espace isolé. D'autres composants de la plateforme (le moteur GitOps, le registre de conteneurs, le service d'authentification unique) ont leur propre petite instance Redis. Comprendre quoi mettre en cache, et ce qui ne doit jamais être perdu, a été l'une des leçons les plus utiles de tout le projet.
Les sauvegardes. Le NAS est la cible centrale des sauvegardes. Les exports des bases de données, les volumes importants des applications et les exports de configuration y arrivent automatiquement, avec une rétention quotidienne et hebdomadaire, et je fais une sauvegarde supplémentaire avant chaque déploiement. Garder les sauvegardes sur un appareil séparé est essentiel : si un serveur — voire tout le cluster — meurt, les copies sont ailleurs. La prochaine étape est une copie hors site des données les plus importantes, pour compléter la règle classique du 3-2-1 (3 copies, 2 supports différents, 1 hors site). Et une sauvegarde ne compte vraiment qu'une fois restaurée : les tests de restauration font donc partie de la routine.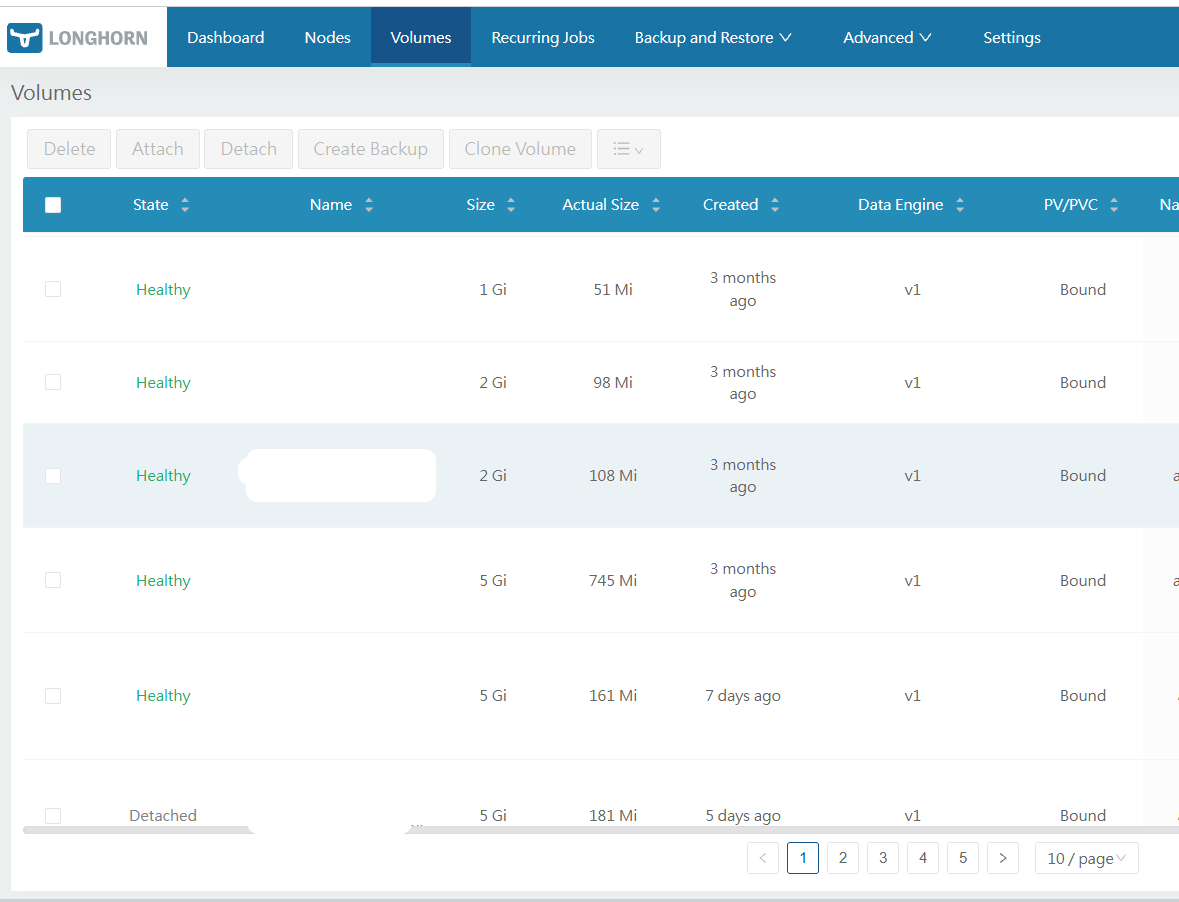
Couche 4 — Du code à la production : GitOps et CI/CD
Rien n'est déployé en cliquant à droite à gauche. Le processus ressemble à celui d'une vraie entreprise :
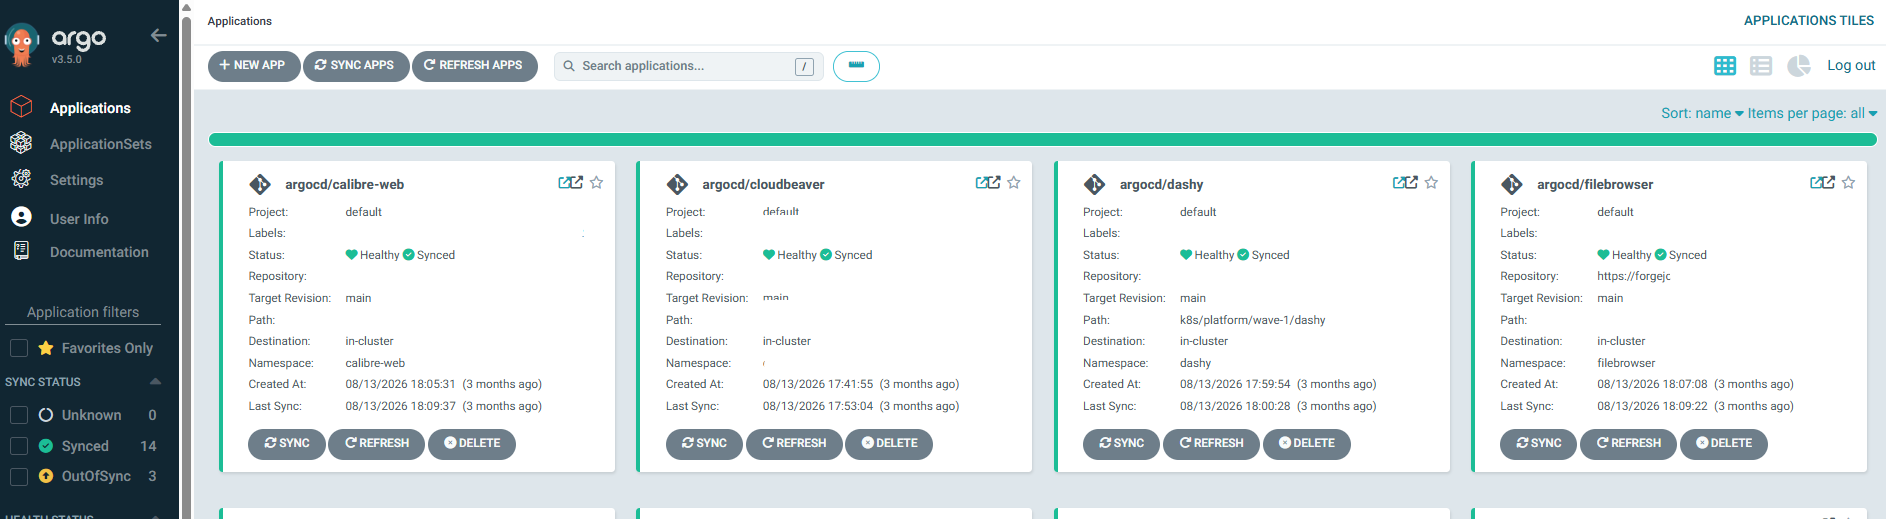
1- Le code vit dans Forgejo, mon serveur Git auto-hébergé.
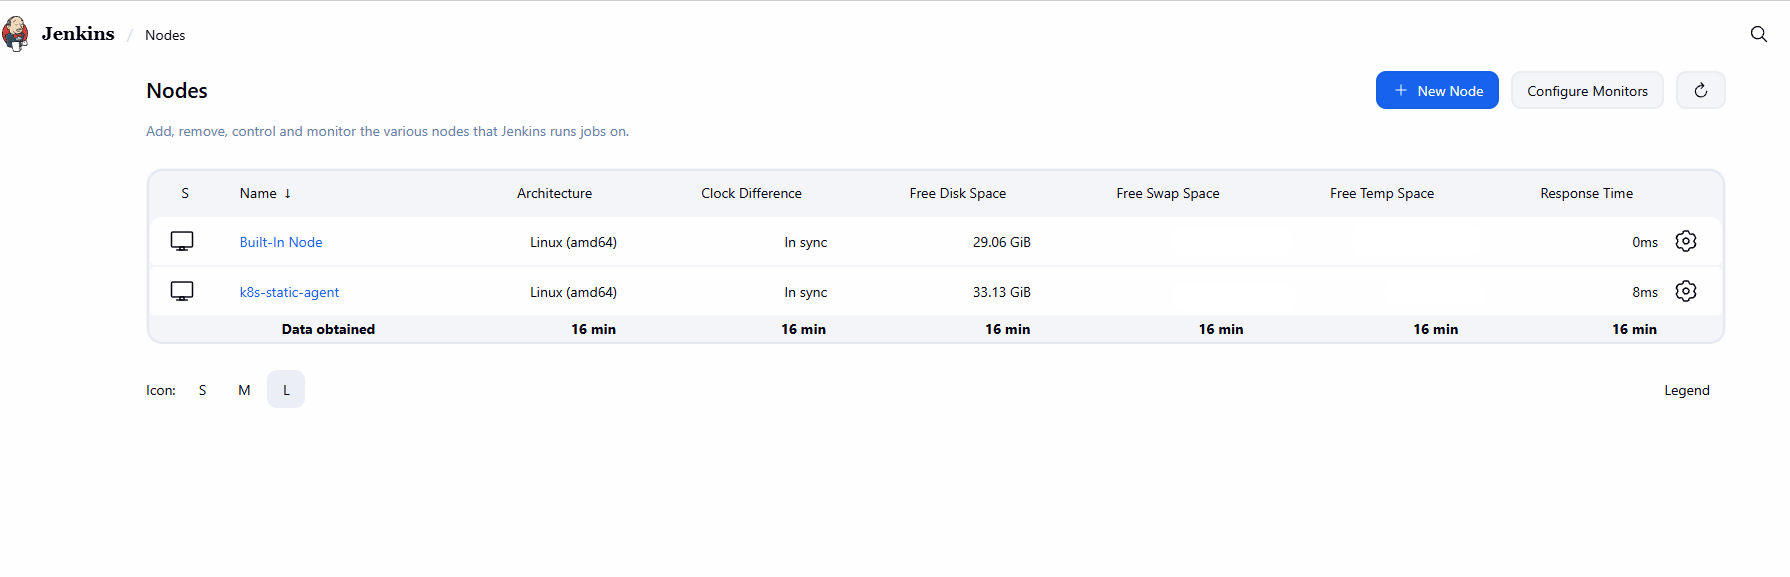
2- Des pipelines CI (Forgejo Actions et Jenkins) lancent les tests, l'analyse de style et les contrôles de sécurité.
3- SonarQube analyse la qualité du code.
4- Les images sont construites et poussées vers Harbor, mon registre de conteneurs privé, qui analyse chaque image à la recherche de vulnérabilités connues. 4- Les images de version sont signées cryptographiquement, et la signature est vérifiée avant le déploiement.
5- Argo CD (GitOps) surveille les dépôts Git et fait en sorte que le cluster corresponde exactement à ce qui y est décrit. Si quelqu'un a modifié quelque chose à la main, Argo CD montre la différence.
6- Des tests de charge k6 me disent comment une application se comporte sous pression avant que je lui fasse confiance.
Résultat : je peux reconstruire n'importe quelle application à partir de Git, et chaque changement a un historique.

Couche 5 — L'observabilité : voir ce qui se passe
On ne peut pas exploiter ce qu'on ne voit pas. La plateforme fait tourner :
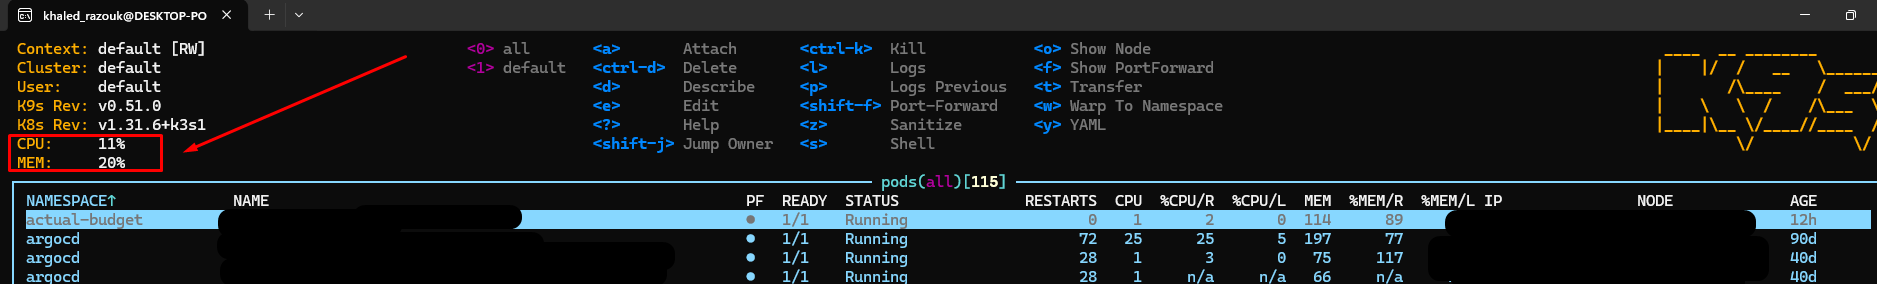
- Prometheus pour collecter les métriques de chaque nœud et de chaque application.
- Des tableaux de bord Grafana pour le cluster, les nœuds, le stockage et mes propres applications.
- Loki pour centraliser les journaux de chaque conteneur, consultables en un seul endroit.
- Des règles d'alerte pour ce qui compte vraiment : un nœud tombé, un disque qui se remplit, une application qui échoue à ses contrôles de santé.
Chaque application expose aussi des contrôles de santé et de disponibilité, pour que Kubernetes sache quand redémarrer quelque chose et quand arrêter de lui envoyer du trafic.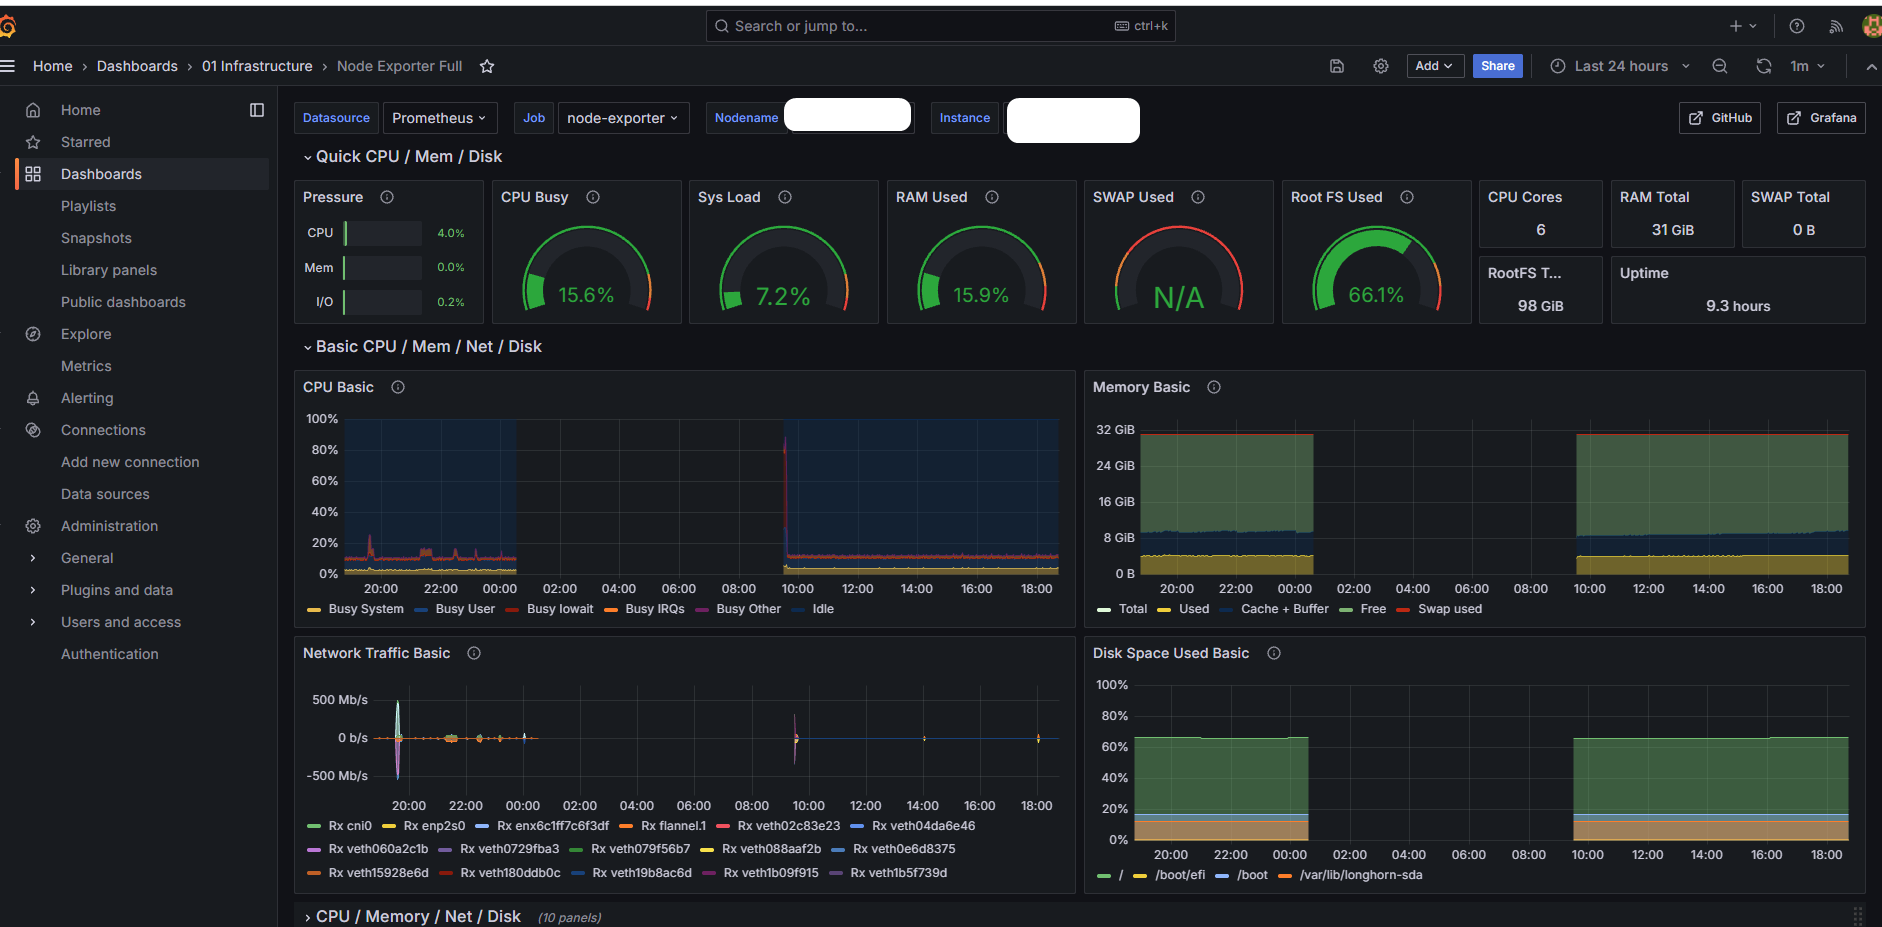
Couche 6 — La sécurité, en profondeur
La sécurité n'est pas un produit, ce sont des couches, chacune partant du principe que la précédente peut échouer. Sans entrer dans les détails de configuration — qui ne doivent jamais être publiés — voici la philosophie :
| Couche | Ce qu'elle fait |
|---|---|
| Privé par défaut | Les outils d'administration ne sont jamais exposés sur Internet. Ils ne sont accessibles que depuis l'intérieur du réseau ou via un VPN chiffré avec une authentification forte à plusieurs facteurs. |
| Une seule porte d'entrée | Les sites publics passent par une passerelle unique, dédiée et isolée. Aucun serveur d'application n'est jamais exposé directement. |
| Réputation d'IP | Les adresses malveillantes connues, partagées par une communauté mondiale, sont refusées avant d'atteindre quoi que ce soit. |
| Pare-feu applicatif (WAF) | Chaque requête est inspectée selon le jeu de règles OWASP, la référence du secteur. Tentatives d'injection, scanners et sondes d'exploitation sont bloqués dès la première requête. |
| Bannissements comportementaux | Les visiteurs qui insistent sont bannis automatiquement, plus longtemps à chaque récidive. |
| Authentification unique | Certaines applications sont derrière un portail de connexion central (Authelia), au lieu que chacune gère ses propres mots de passe. |
| Segmentation réseau | Même si une application était compromise, le pare-feu limite ce qu'elle peut atteindre. |
| Charges de travail durcies | Les conteneurs tournent sans droits root, avec un système de fichiers en lecture seule, des privilèges minimaux et des politiques réseau strictes. |
| Chaîne d'approvisionnement | Registre privé, analyse de vulnérabilités, images signées, versions figées. |
| Secrets | Les mots de passe et les clés ne sont jamais stockés dans Git ; les secrets des applications sont chiffrés au repos. |
| Chiffrement partout | HTTPS sur chaque service, connexions chiffrées aux bases de données, VPN chiffré. |
La leçon la plus précieuse ici : testez votre sécurité comme le ferait un attaquant. Je lance régulièrement des simulations d'attaques inoffensives contre ma propre porte d'entrée, et je vérifie que chacune est bloquée — et que le trafic normal, lui, ne l'est pas.

Ce qui tourne vraiment dessus
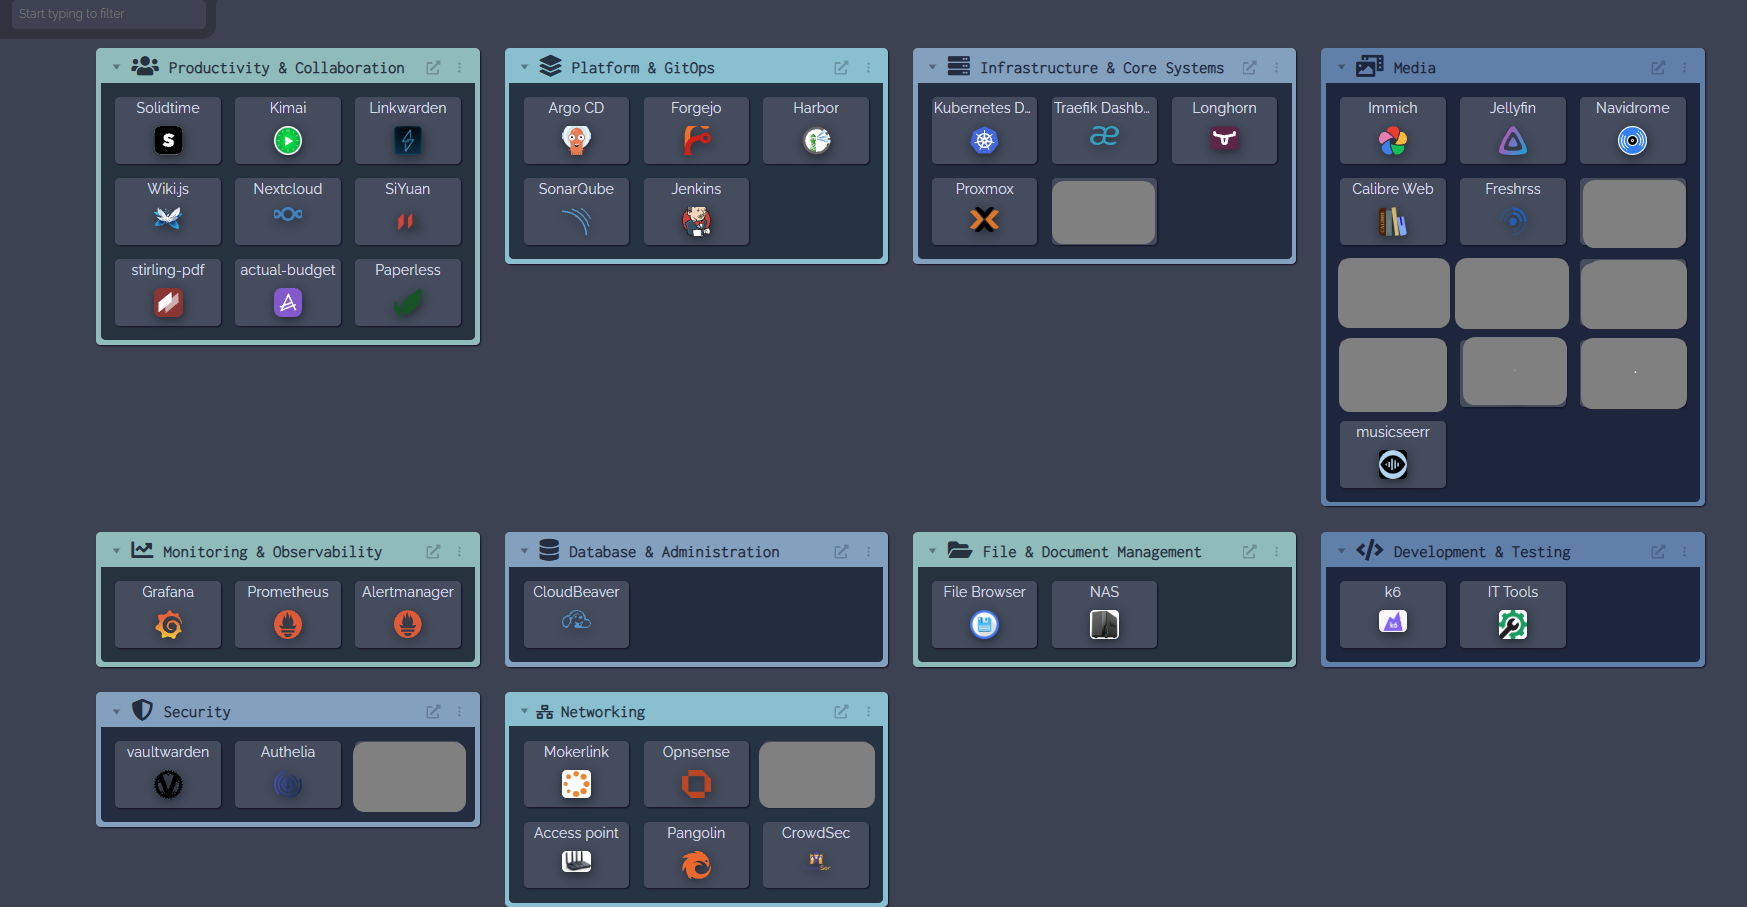
La partie la plus sympa — la plateforme existe pour faire tourner des choses. Tout ce qui suit est auto-hébergé, sur mon propre matériel :
Mes propres projets
Mes propres applications web, que je développe moi-même et que je déploie via le même pipeline que tout le reste.
Mes sites personnels, hébergés ici gratuitement.
Productivité & cloud personnel
Nextcloud — fichiers, calendrier et contacts.
Paperless-ngx — documents numérisés, consultables grâce à l'OCR.
Immich — ma photothèque et vidéothèque (un Google Photos auto-hébergé).
Vaultwarden — gestionnaire de mots de passe.
Linkwarden — favoris et pages web archivées.
FreshRSS — lecteur d'actualités.
SiYuan — notes et base de connaissances.
Wiki.js — la documentation de la plateforme elle-même.
Stirling-PDF — boîte à outils PDF.
Filebrowser — gestionnaire de fichiers web.
Actual Budget — finances personnelles.
Kimai et Solidtime — suivi du temps.
wger — suivi des entraînements sportifs.
Médias & divertissement
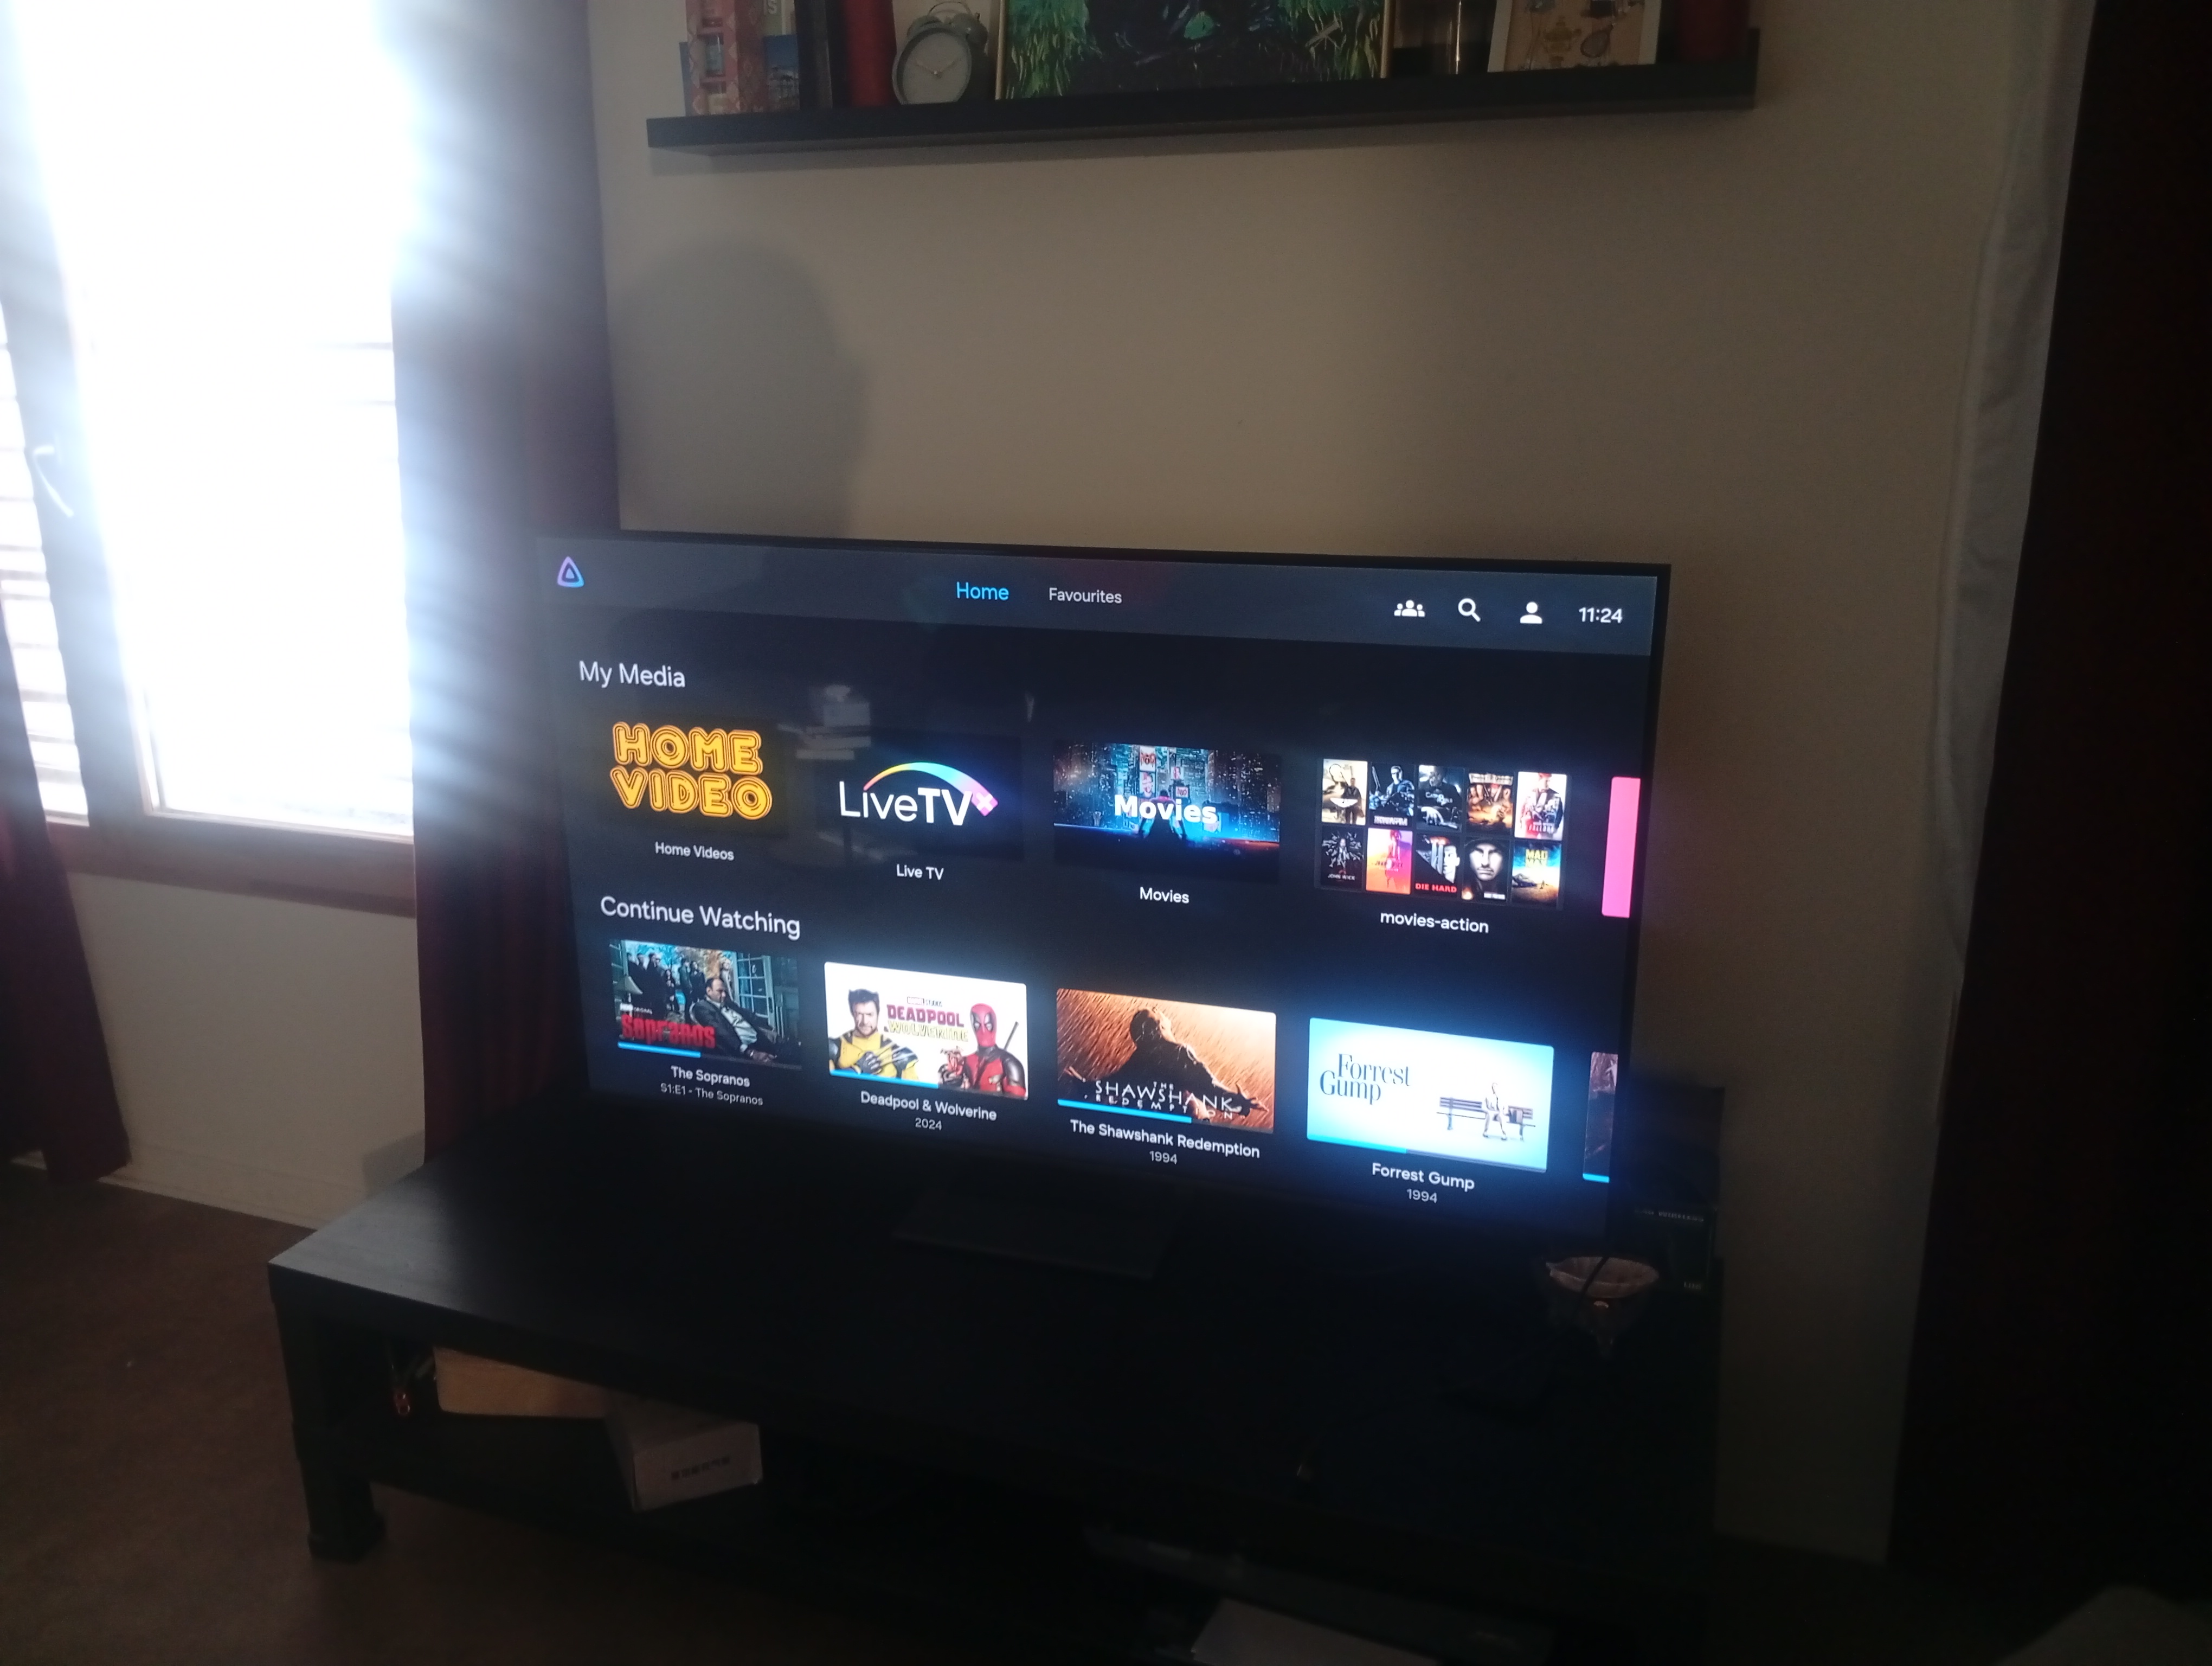
Jellyfin — ma bibliothèque de films et de séries, diffusée sur n'importe quel écran.
Navidrome — ma bibliothèque musicale.
Calibre-Web — livres numériques.
Plateforme & outils de développement
Forgejo, Jenkins, SonarQube, Harbor, Argo CD — la chaîne de livraison.
Grafana, Prometheus, Loki — l'observabilité.
Kubernetes Dashboard, CloudBeaver (administration des bases), IT-Tools — l'exploitation.
Dashy — la page d'accueil qui relie tout.

Les avantages, en toute honnêteté
- Zéro facture d'hébergement mensuelle. Environ 5 000 € de matériel, achetés petit à petit, et ensuite seulement l'électricité — pour 8 serveurs, plus de 200 Go de RAM, 28 To de stockage et plus de 40 services.
- Mes données restent les miennes. Photos, documents, mots de passe et notes vivent sur du matériel qui m'appartient.
- Un vrai labo, pas un simulateur. Chaque notion vue dans une certification ou une offre d'emploi, je l'ai configurée, cassée et réparée moi-même.
- Des réflexes de production. Infrastructure as code, GitOps, supervision, sauvegardes, couches de sécurité — les mêmes pratiques qu'en entreprise, à une échelle que je maîtrise entièrement.
- Des expériences rapides. Un nouvel outil passe de « j'en ai entendu parler » à « il tourne, supervisé et sauvegardé » en une soirée.
Et ensuite ?
- Déplacer la passerelle exposée à Internet vers un petit serveur dans le cloud, pour que ma connexion à la maison ne soit jamais exposée directement.
- Compléter la stratégie de sauvegarde 3-2-1 avec une copie hors site, en plus du NAS.
- Mettre à profit la partie encore inutilisée des 28 To pour de nouveaux projets.
- Davantage de tests de restauration automatisés pour chaque base de données.
- Une meilleure remontée des alertes sur mon téléphone.
- Et, bien sûr, de nouvelles applications pour continuer à apprendre.
Ce homelab a commencé comme un projet d'apprentissage et il est devenu la plateforme que j'utilise tous les jours. Si vous pensez à en construire un : commencez petit, écrivez tout sous forme de code, et n'ayez pas peur de casser des choses — c'est là que l'on apprend vraiment.